A camada de inteligênciapara o Checkmk.
A sua monitorização já sabe que algo está errado. O Pardinus determina a causa, apresenta as evidências utilizadas, um grau de confiança e o passo seguinte, que aguarda a sua aprovação. Dentro do Checkmk e com o modelo que escolher.
Entrega
Um MKP para Checkmk. Sem extensões e sem uma segunda consola.
Modelo
Utilize o seu próprio modelo. Qualquer endpoint compatível com OpenAI.
Ações
Nada é executado sem que uma pessoa selecione Executar.
Custo
Consumo de tokens acompanhado por site, utilizador e operação.
O problema
Seis alertas. Uma causa.
Um host saturado, uma base de dados lenta, um checkout com falhas e um limite de memória atingido num nó. A monitorização apresenta-os como problemas independentes, às três da manhã, a uma única pessoa.
O Pardinus analisa-os em conjunto, recorrendo ao histórico de situações semelhantes, e devolve um único incidente investigado.
O que está incluído na suite
Nove módulos, um add-on
O Pardinus começou como uma solução de chat e análise de causa raiz. É agora a camada operacional em torno dessas duas capacidades: o que verificar primeiro, o que executar, o que aprender, quanto custa e quem aprova.
Investigar
Um diagnóstico com grau de confiança, os dados do Checkmk que o sustentam e o agente especializado que o produziu.
Diagnóstico rápido
Um playbook só de leitura por tipo de alerta. Um comando conhecido, output em bruto e sem consumo de tokens.
Plano de ação
Correções sugeridas que pode editar, selecionar e aprovar. Todas as execuções utilizam SSH e ficam registadas para auditoria.
Análise proativa da causa raiz
Uma análise iniciada assim que um serviço entra em estado crítico, delimitada por um ruleset normal do Checkmk.
Análise de tendências
Padrões recorrentes, serviços que ocorrem em conjunto e oportunidades de afinação, calculados antes de qualquer conteúdo ser gerado.
Base de conhecimento
As conclusões só se tornam conhecimento reutilizável após aprovação humana, acompanhadas de uma nota sobre a respetiva causa.
Auditor de configurações
Uma pontuação de risco para o site: regras sobrepostas, duplicados, limiares em falta e qualidade geral da configuração.
Chat
Questões sobre o ambiente a partir de qualquer dashboard, no seu idioma e com histórico por utilizador.
Estado e custos
Automonitorização e custo de tokens por site, operação e utilizador, com projeção para o final do mês.
Topologia dinâmica
A sua infraestrutura, mapeada a partir do Checkmk
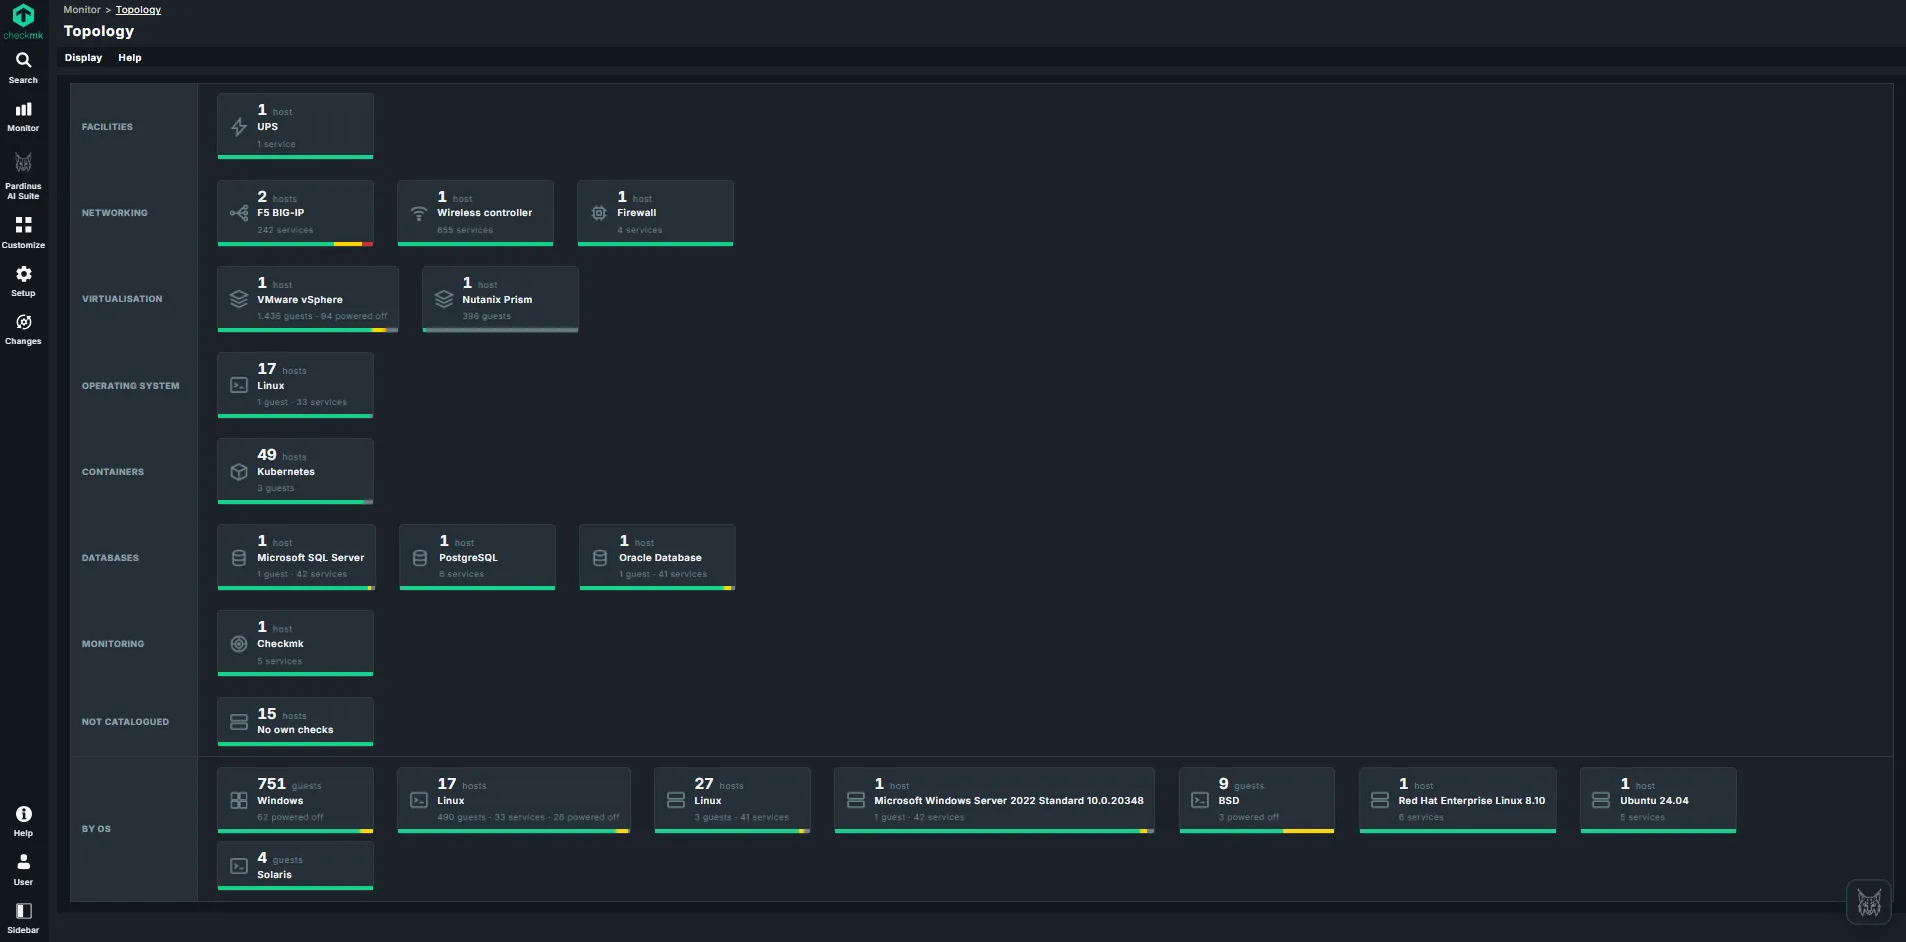
O Pardinus constrói um modelo de dependências a partir das verificações já executadas nas suas máquinas. Explore a infraestrutura por camada e consulte as relações que ajudam a explicar como uma falha se propaga.
Comece pela matriz da infraestrutura
Consulte redes, virtualização, sistemas operativos, contentores e bases de dados num único catálogo. Cada cartão identifica o produto, o respetivo estado e se a contagem corresponde a hosts, máquinas virtuais ou serviços.
- Classificação baseada nas verificações existentes do Checkmk
- Pesquisa por categoria, produto, função, tipo ou sistema operativo
- Combinação de filtros com AND, OR e NOT
Siga as dependências por detrás de um alerta
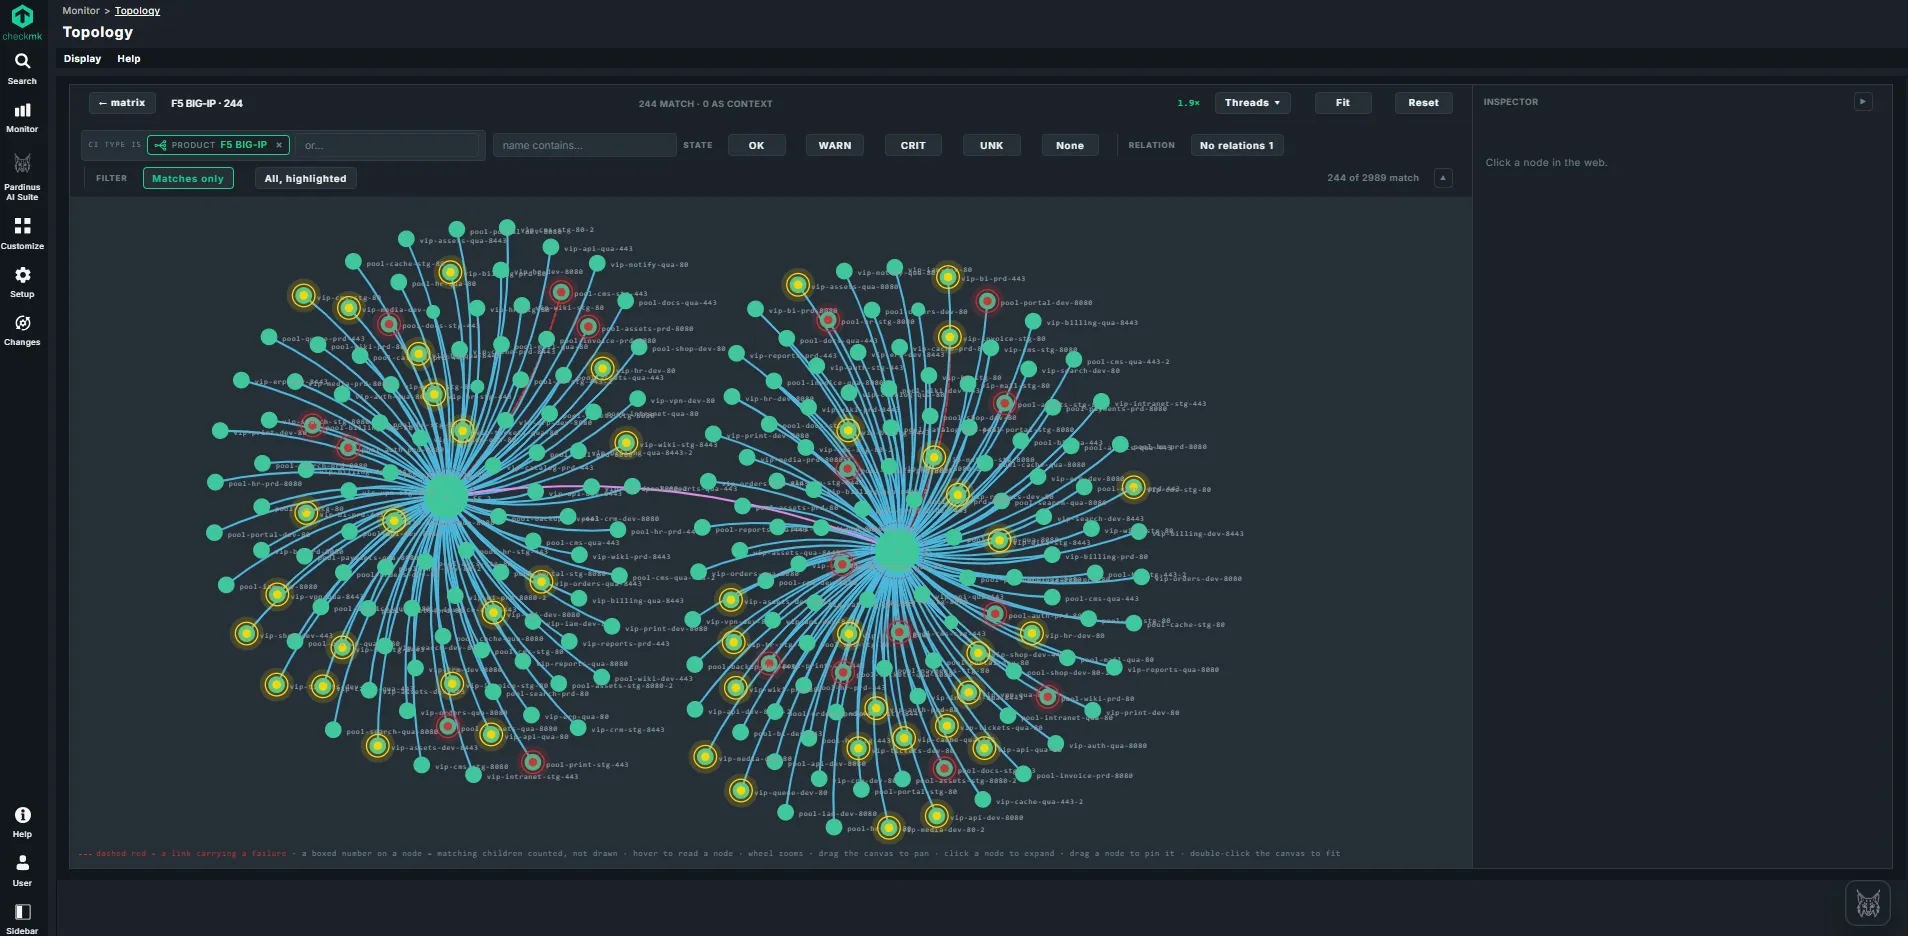
Abra um produto para explorar o respetivo grafo de dependências. Neste exemplo, dois hosts F5 BIG-IP estão ligados aos seus pools e serviços virtuais, com estados de aviso e críticos visíveis no mapa.
- Filtragem por estado e consulta de cada nó e das suas relações
- Seguimento da propagação de falhas através de regras explícitas para cada relação
- Caminhos de dependência disponíveis para avaliar o alcance de uma falha na análise de causa raiz
Quando vários hosts falham em simultâneo, a análise de causa raiz percorre a cadeia de dependências para distinguir a falha de origem dos sintomas nos sistemas dependentes e concentrar a investigação na causa mais provável.
Investigar
Cada problema encaminhado para o especialista certo
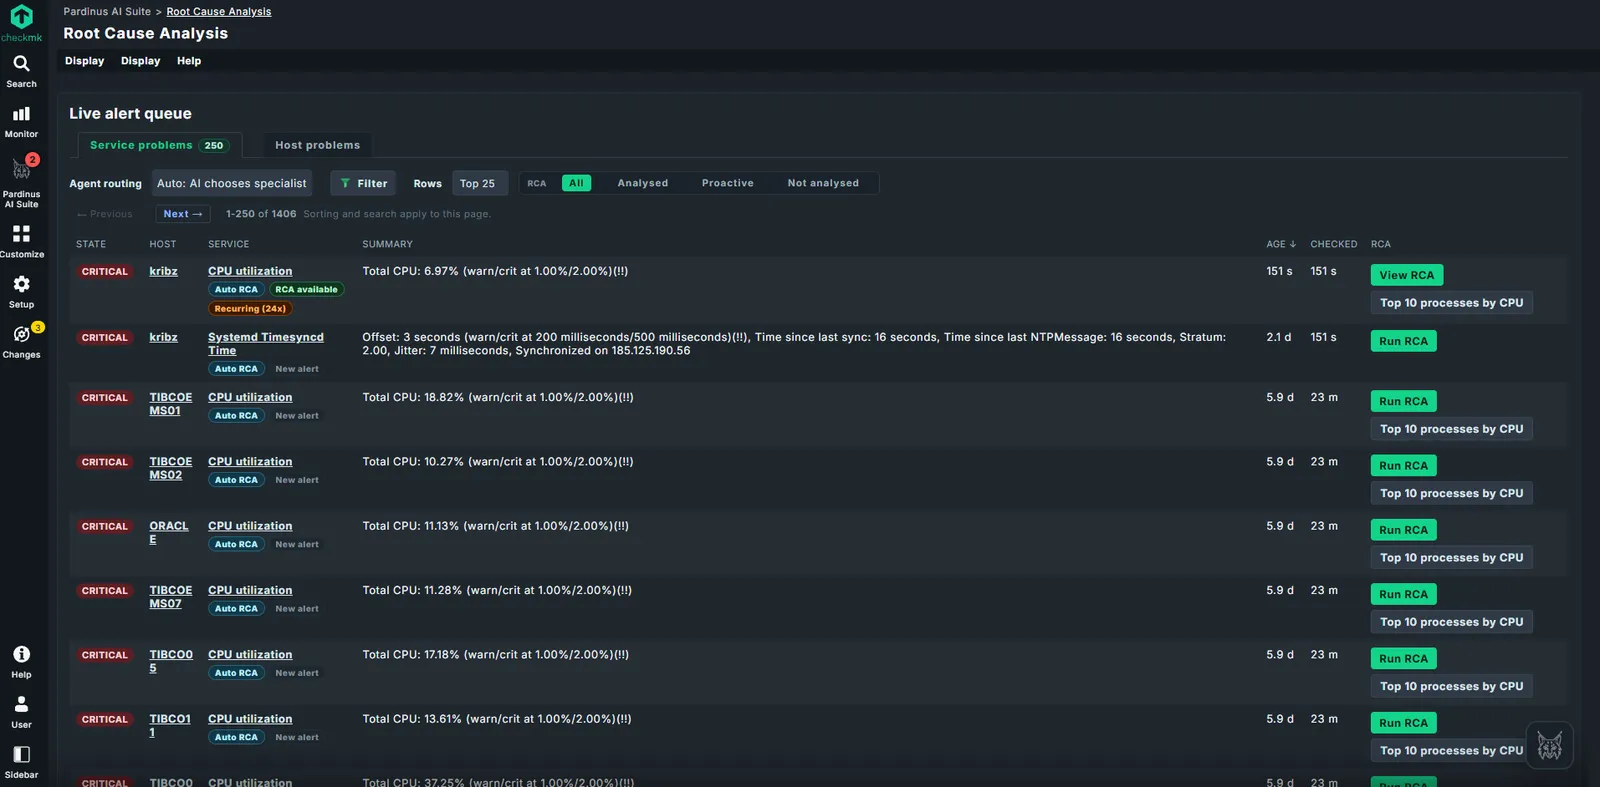
A fila em tempo real apresenta problemas de hosts e serviços com o estado da respetiva análise: já analisados, selecionados automaticamente ou ainda por analisar. O encaminhamento entre Linux, Windows, bases de dados e redes é automático e pode ser substituído em cada alerta.
A fila mostra o ponto de situação
Os alertas repetidos são assinalados como tal, com a respetiva contagem. Um alerta que já tem resposta apresenta essa resposta em vez de uma nova análise.
- Análise de causa raiz automática, a pedido ou inexistente, visível em cada linha
- Alertas repetidos sem alterações reutilizam o resultado anterior
- Filtragem por site, host, pasta ou padrão de serviço
Um diagnóstico que pode ser questionado
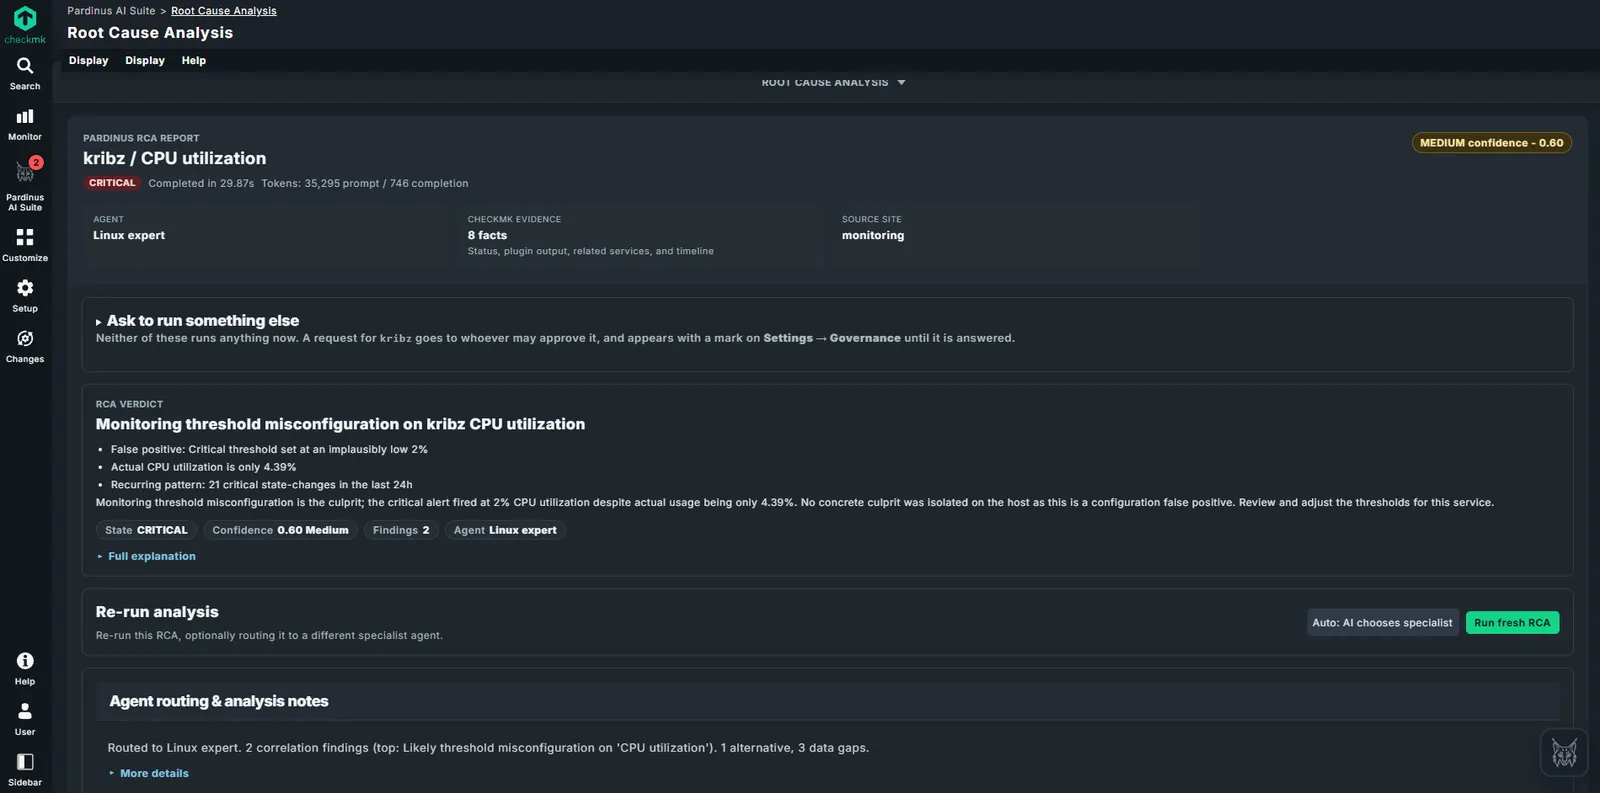
O relatório identifica a causa provável, avalia o próprio grau de confiança e apresenta os dados do Checkmk utilizados. Quando as evidências são insuficientes, indica-o claramente em vez de preencher as lacunas.
- Grau de confiança com alternativas e lacunas nos dados
- Conjunto completo de evidências que sustenta a resposta
- Gráfico de desempenho do serviço incluído no relatório
- Possibilidade de repetir a análise com outro agente especializado
Nesta execução, não foi identificado qualquer incidente: o limiar crítico estava definido em 2%, a utilização real era de 4,39% e o alerta tinha oscilado 21 vezes num dia.
Responder primeiro, gastar depois
Nem todos os alertas precisam de um modelo
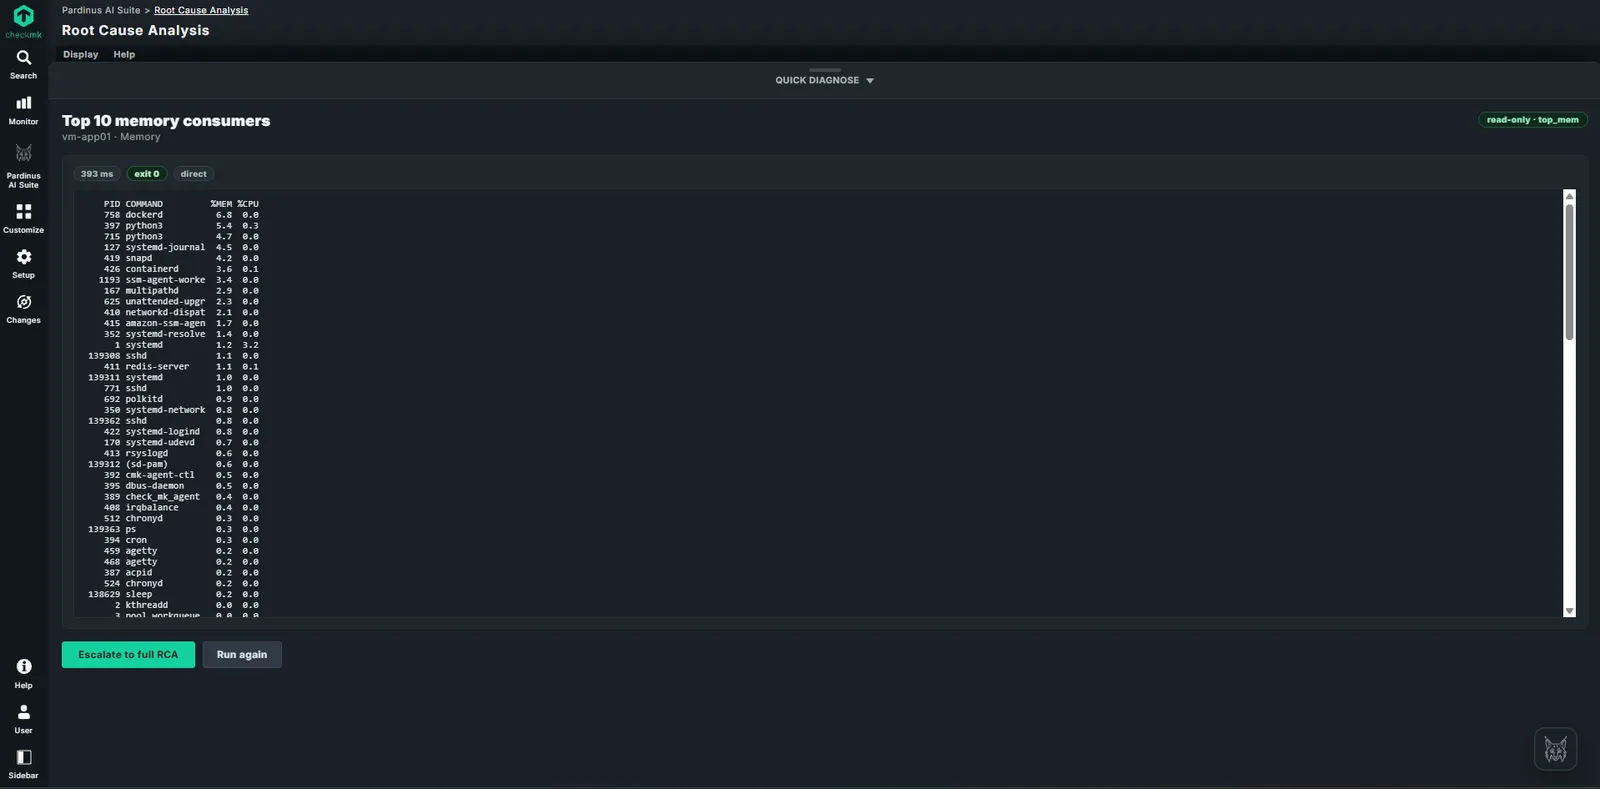
A maioria das questões durante o serviço de prevenção é respondida por um único comando. O Diagnóstico rápido executa-o como uma verificação determinística e só de leitura, em cerca de um segundo, propondo uma análise completa apenas quando o resultado não é suficiente.
Diagnóstico rápido
Um playbook identificado e associado ao tipo de alerta: processos com maior consumo de CPU, maiores consumidores de memória ou crescimento do sistema de ficheiros. Output em bruto, código de saída e duração.
- Só de leitura por conceção, sem alterar o host
- Sem consumo de tokens
- Um botão para avançar para uma análise completa
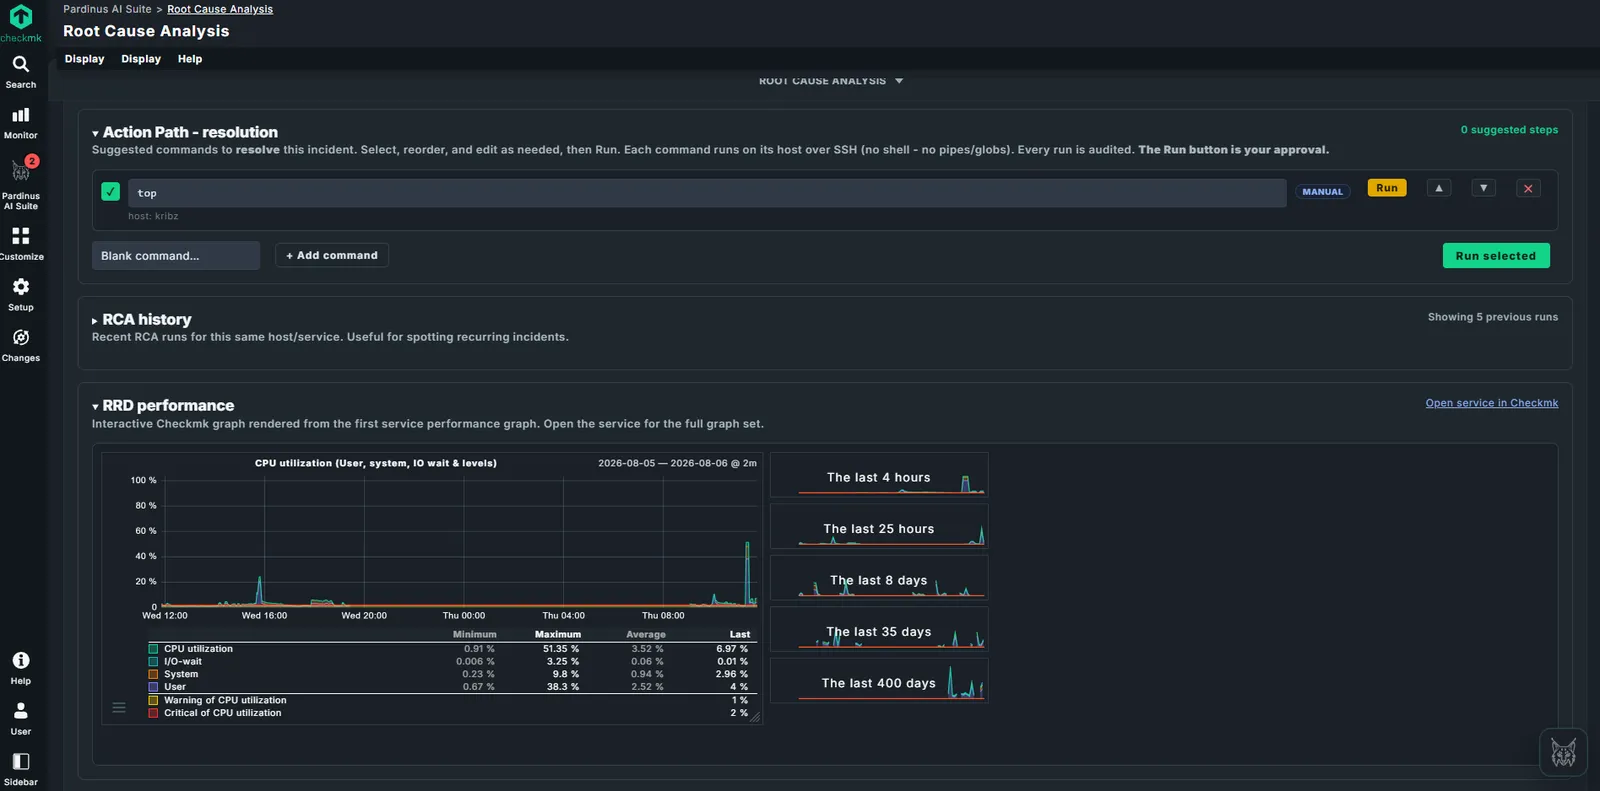
Plano de ação: o botão Executar representa a aprovação
Quando uma análise sugere uma correção, os passos são apresentados como uma lista editável. Pode selecionar, reordenar, editar e executar. Os comandos são executados através de SSH, sem shell, pipes ou globs; qualquer comando fora da lista permitida tem de ser previamente solicitado e autorizado.
- Limites de concorrência por host e deteção de ciclos
- Credenciais provenientes do password store do Checkmk
- Todas as execuções registadas no log de auditoria
Nativo
Configurado no Checkmk, não ao lado
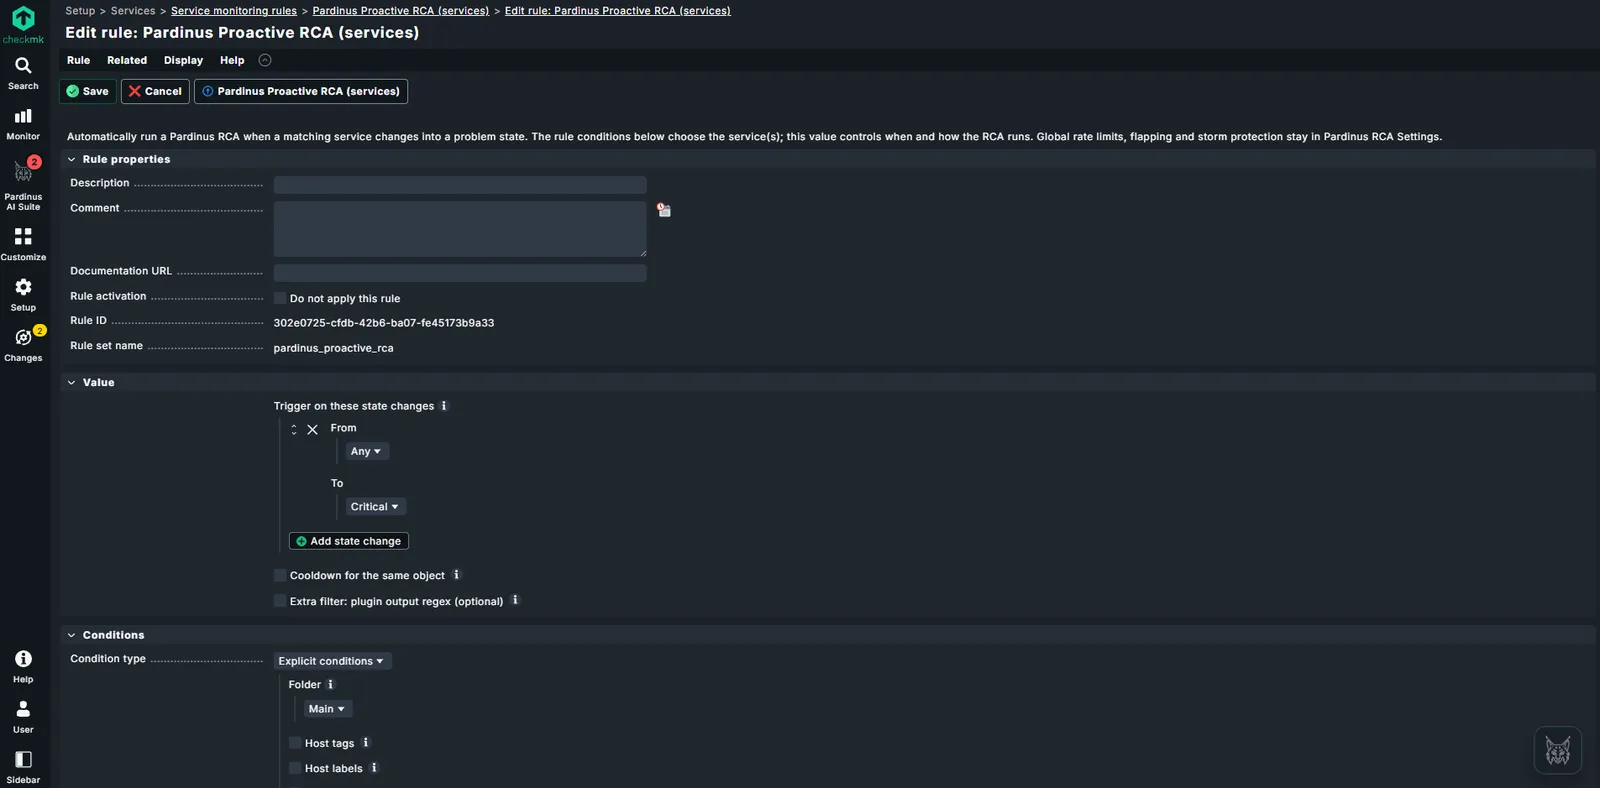
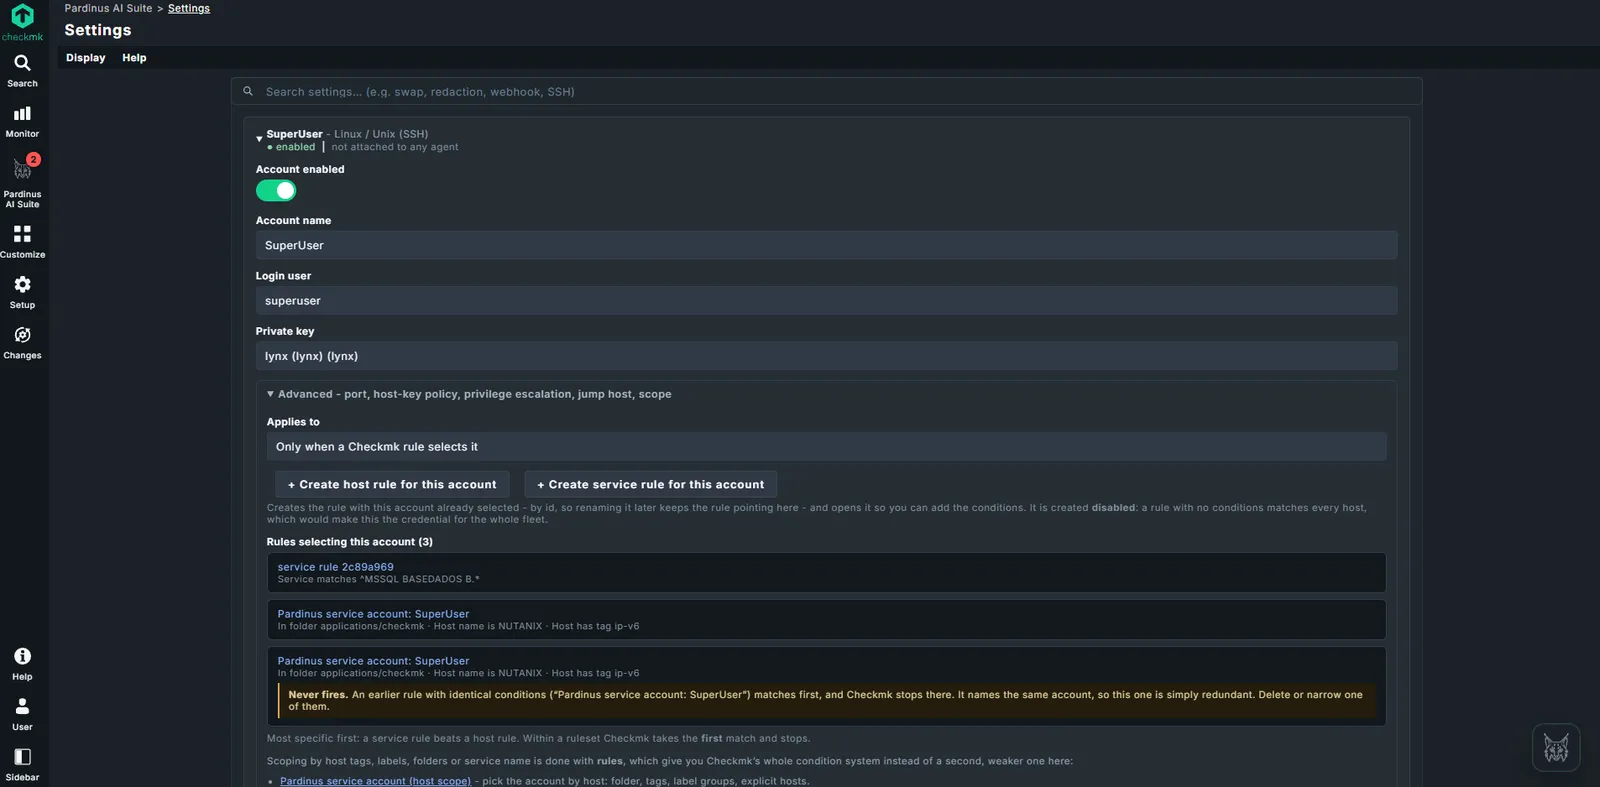
A delimitação é efetuada onde a sua equipa já configura tudo o resto. A análise proativa e as contas SSH utilizadas são rulesets normais, com pastas, host tags, labels e hosts explícitos, seguindo o comportamento habitual em que a primeira correspondência prevalece.
Rulesets, não uma configuração paralela
Escolha que serviços iniciam autonomamente uma análise, perante que mudança de estado e com que período de espera. Escolha que máquinas utilizam cada login. Sem nada de novo para aprender além do que já conhece no Checkmk.
- Análise proativa delimitada por uma regra de serviço
- Contas de serviço delimitadas por uma regra de host
- Regras sobrepostas detetadas e explicadas, em vez de ignoradas silenciosamente
Pardinus Core
Um serviço dedicado ao trabalho por detrás de cada análise
O Pardinus Core executa análises, tarefas de tendências e relatórios agendados como um serviço dedicado, gerido pelo OMD. Dispõe da sua própria fila, agendador e estado de funcionamento, permitindo que as investigações prolongadas decorram de forma independente da interface do Checkmk.
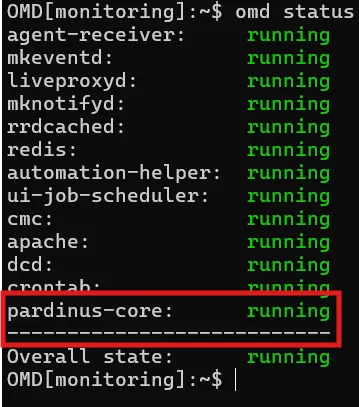
Tarefas em fila, estado visível
Inicie, pare e monitorize o pardinus-core juntamente com os restantes serviços do Checkmk. A fila partilhada mantém o trabalho em execução quando um operador atualiza a página, enquanto as verificações de estado e os registos de erros mostram o que requer atenção.
- Análises em fila, execuções agendadas de tendências e relatórios periódicos
- Novas tentativas com intervalos crescentes e interrupção temporária quando o fornecedor falha
- Verificações de ligação, estado por site e erros do produto na interface
Aprender
A segunda ocorrência deve custar menos do que a primeira
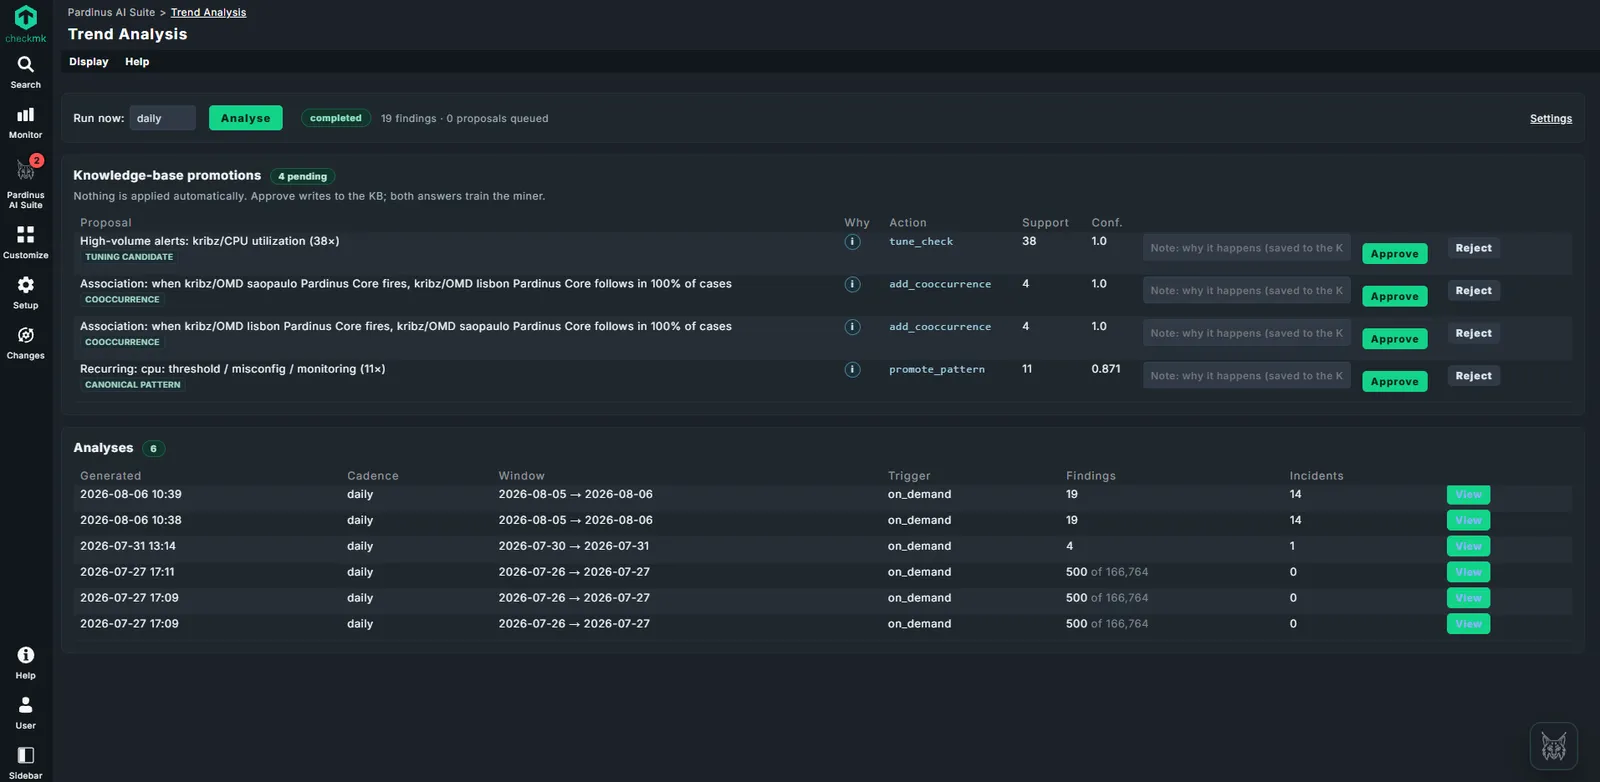
As estatísticas são calculadas periodicamente sobre o histórico de incidentes: alertas de elevado volume que devem ser afinados, serviços que falham sempre em conjunto e padrões recorrentes. Os números são calculados de forma determinística; o modelo apenas redige a explicação.
Nada entra autonomamente na base de conhecimento
As propostas aguardam numa fila com o número de ocorrências e o respetivo grau de confiança. Pode aprová-las ou rejeitá-las, adicionando opcionalmente a causa. Ambas as respostas melhoram a análise seguinte.
- Oportunidades de afinação para alertas demasiado frequentes
- Serviços que ocorrem em conjunto em diferentes sites
- Padrões canónicos recorrentes com ocorrências e grau de confiança
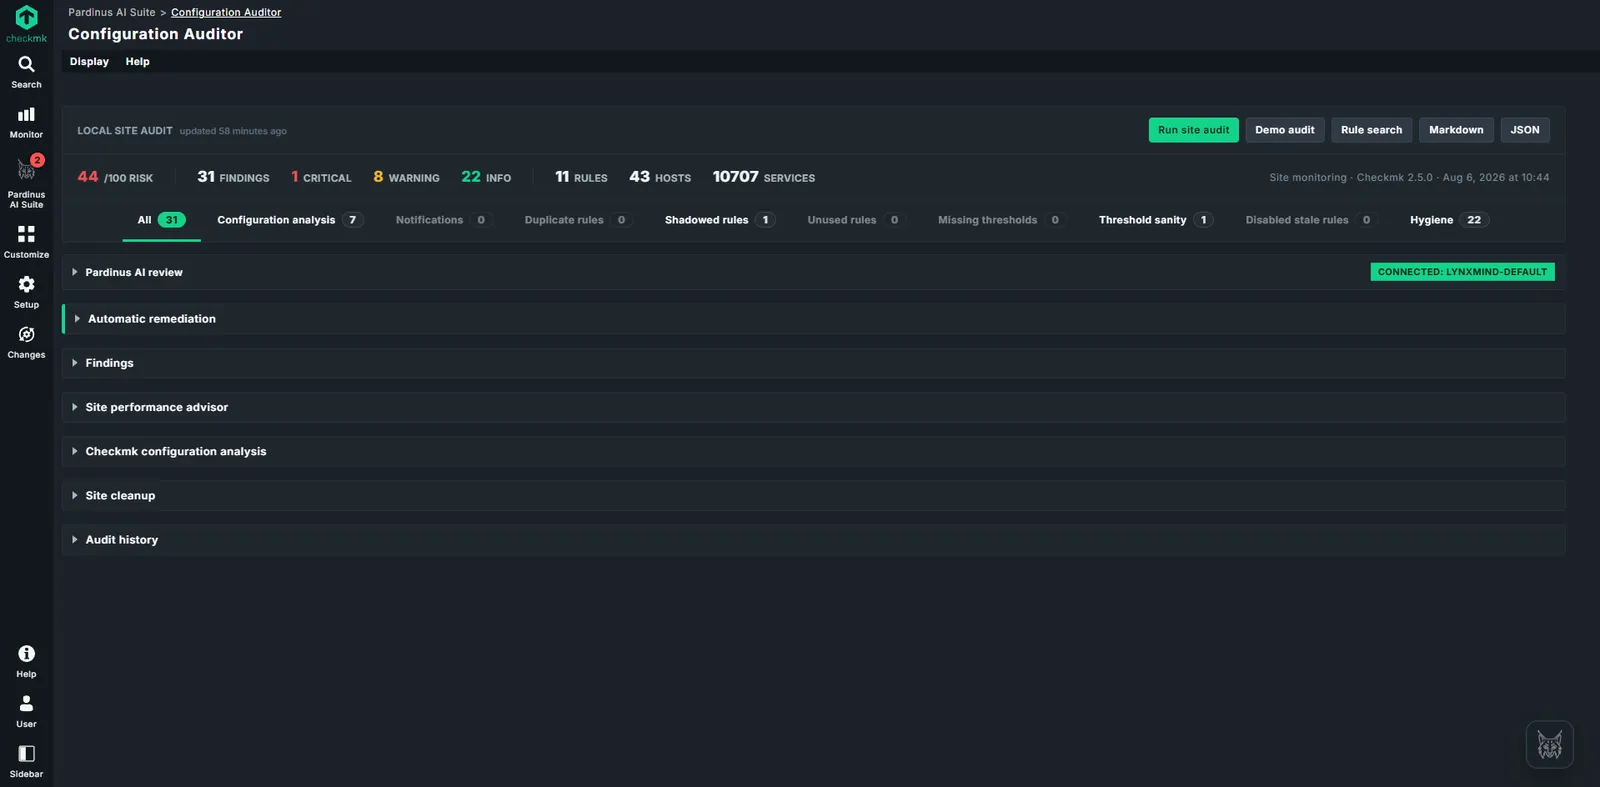
A própria configuração também é revista
O Auditor de configurações atribui uma pontuação ao site e enumera os problemas encontrados: regras duplicadas ou sobrepostas, regras que nunca correspondem e limiares em falta ou pouco plausíveis. Os resultados podem ser exportados em Markdown ou JSON.
- Pontuação de risco com conclusões críticas, de aviso e informativas
- Consultor de desempenho do site e sugestões de limpeza
- Histórico de auditorias para acompanhar a evolução
Perguntar
Converse com o seu ambiente a partir de qualquer dashboard
Respostas adaptadas ao contexto
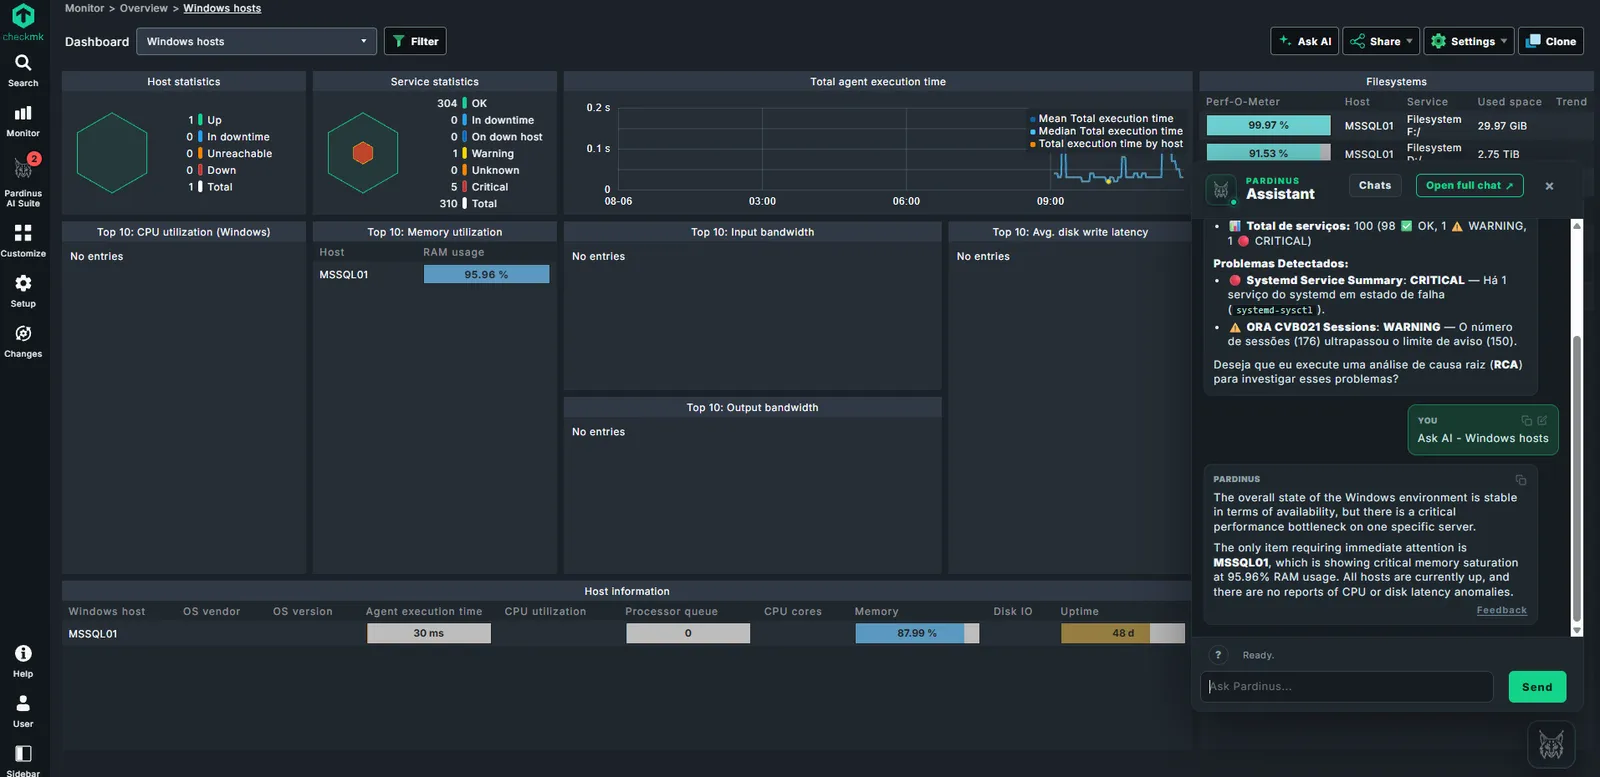
O assistente surge ao lado da vista que está a consultar. Pergunte sobre um host, um serviço, um dashboard que não reconhece ou um conceito do Checkmk e obtenha uma resposta sobre os seus sistemas, não uma citação da documentação.
- Painel lateral em qualquer dashboard ou página completa com histórico
- Respostas no idioma utilizado na pergunta
- Possibilidade de iniciar uma análise completa quando é detetado um problema
- Entrada por voz e respostas faladas
Controlo
Sempre sob controlo humano
Uma IA próxima da monitorização de produção exige maior controlo do que um dashboard. Permissões, custos e comportamento são configurações, não promessas; quando um agente pretende realizar uma ação não autorizada, solicita aprovação e aguarda.
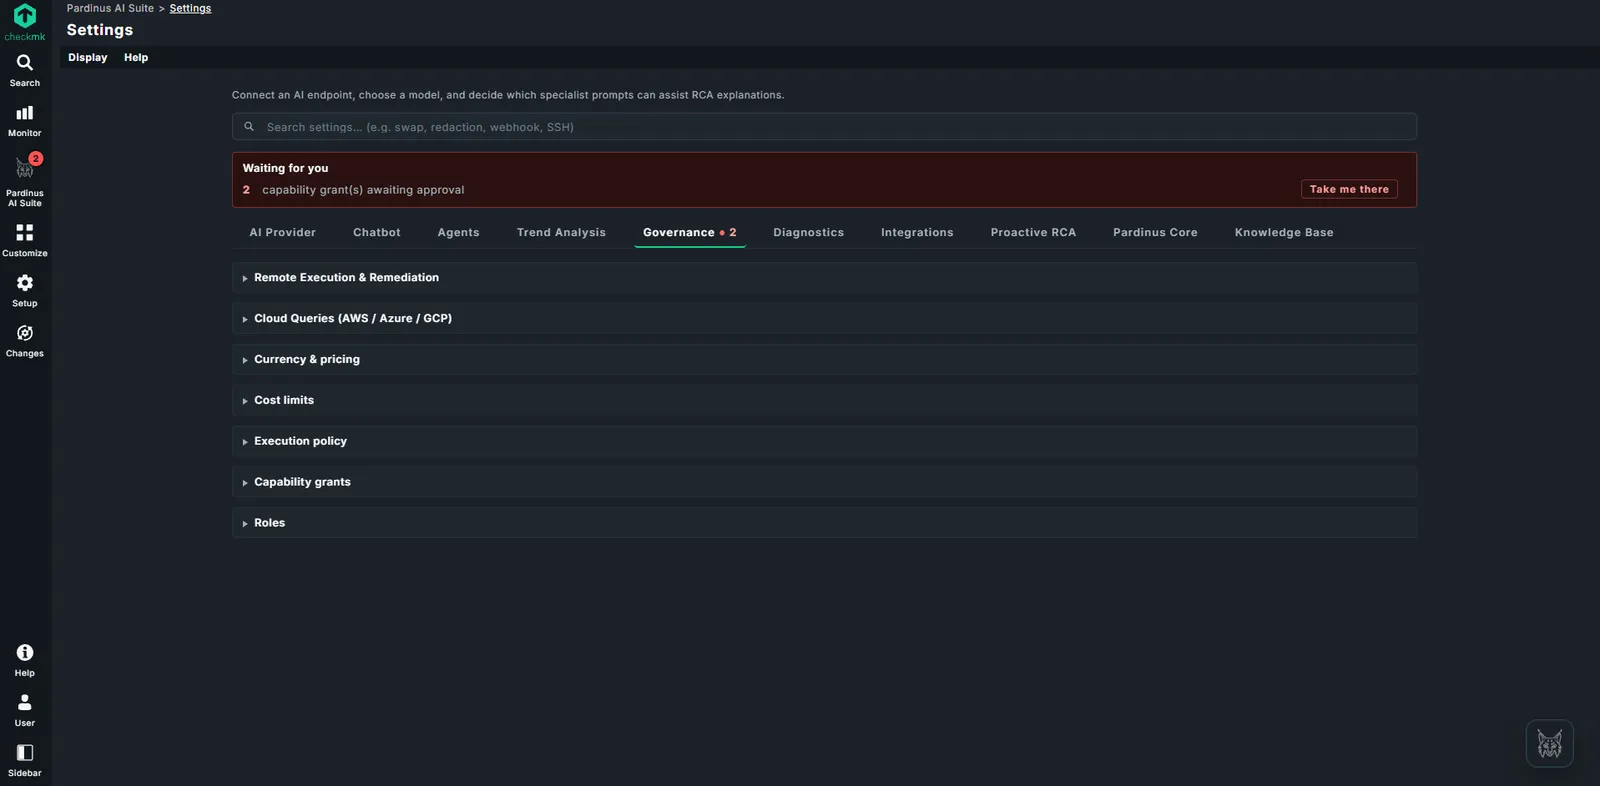
A governação é um separador, não uma nota de rodapé
- Autorizações de capacidades em fila para aprovação humana
- Política de execução e listas de comandos permitidos
- Limites de custos por site e por período
- Permissões por função dentro do Checkmk
- Ocultação de valores sensíveis antes de qualquer envio
Quanto custa e qual é o seu estado
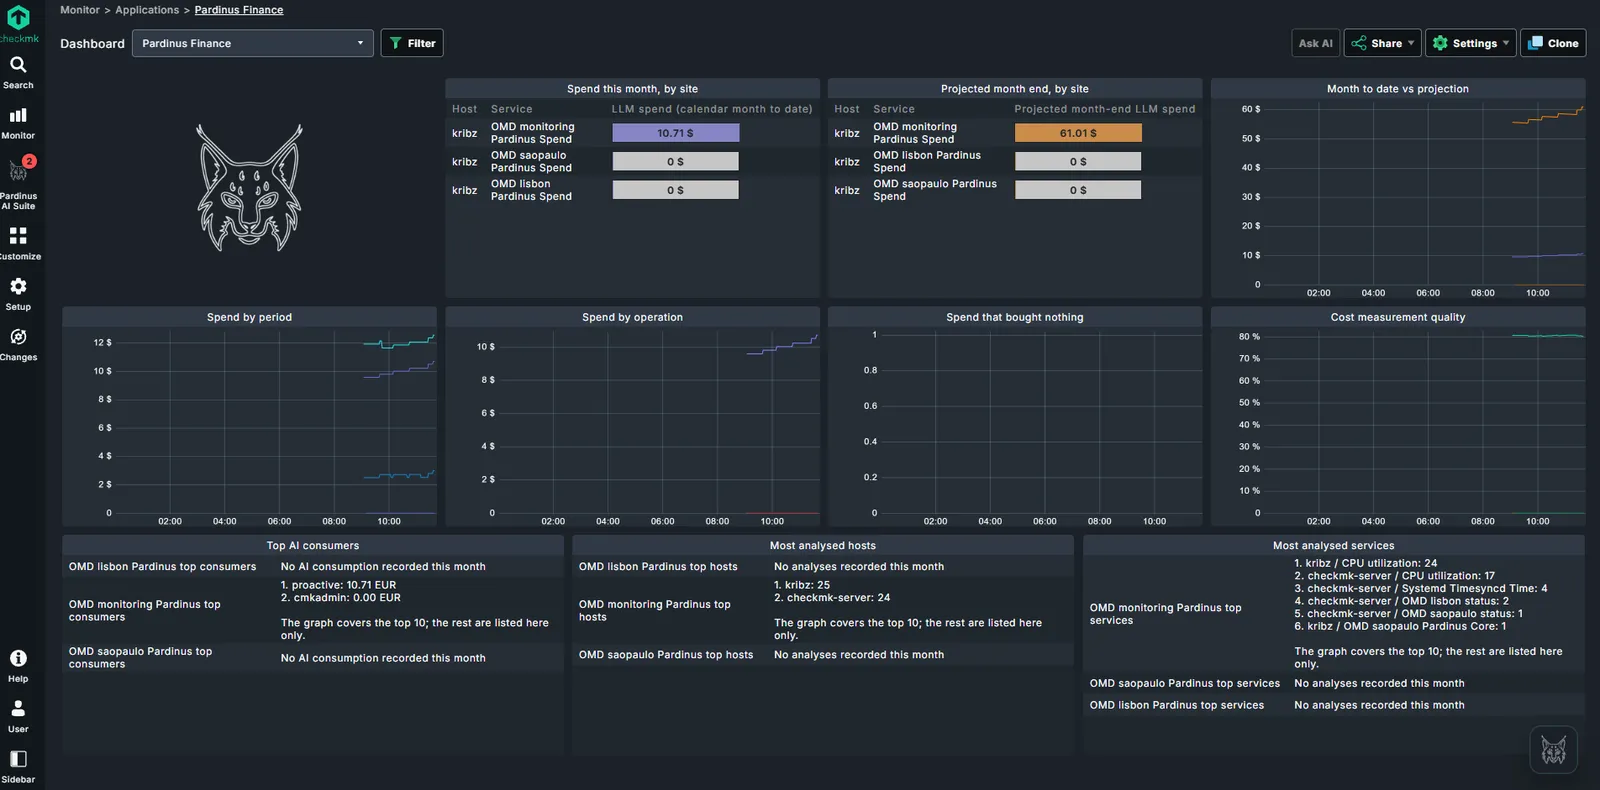
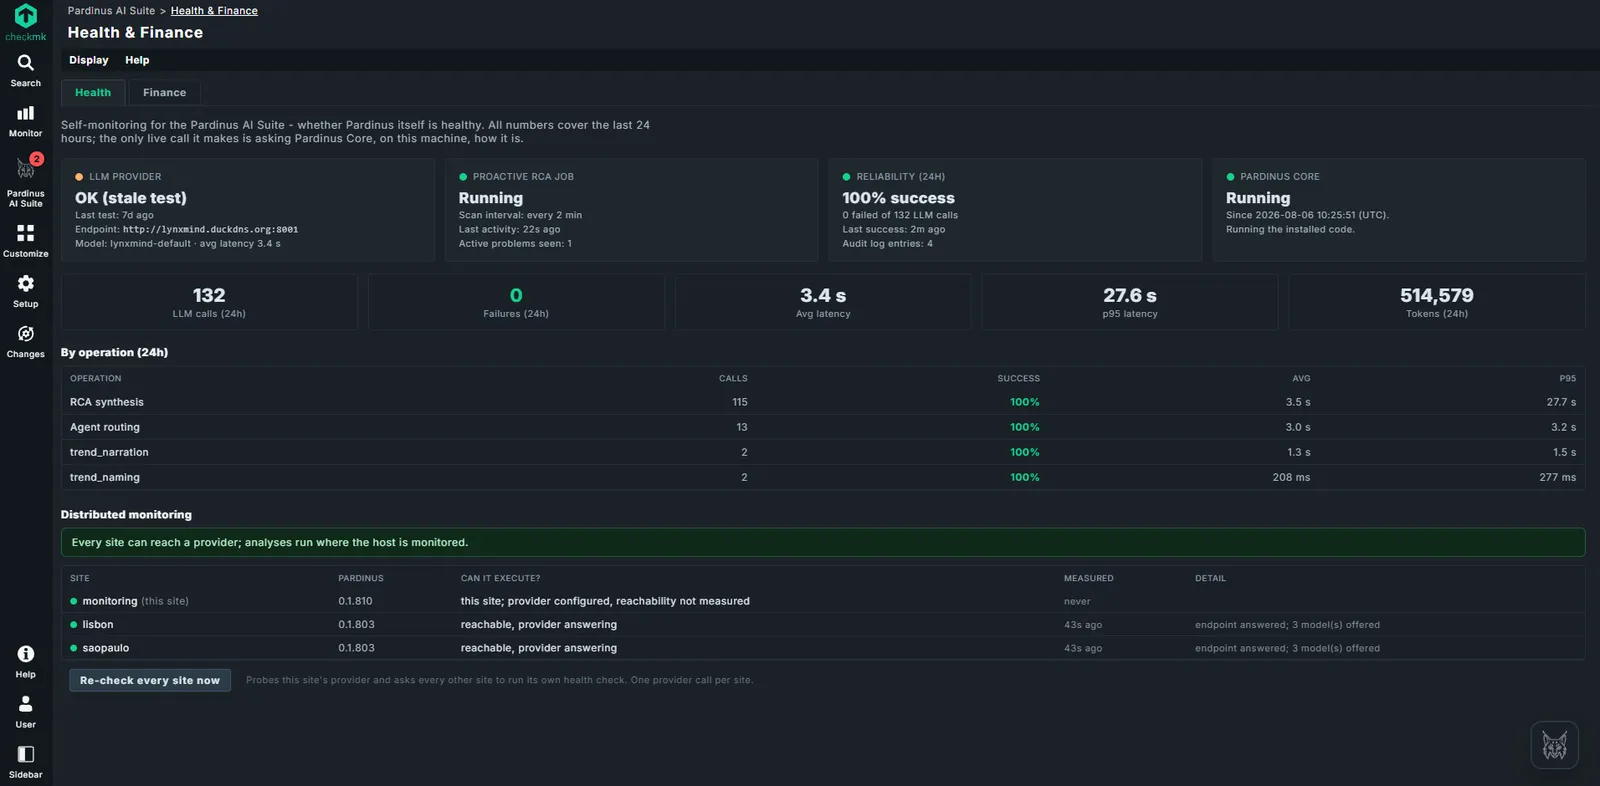
O consumo de tokens é acompanhado por site, operação e utilizador, com uma projeção para o final do mês e uma resposta clara à questão incómoda: quanto deste custo não gerou valor porque o alerta já tinha sido analisado.
- Despesa acumulada no mês face à projeção, por site
- Tokens poupados através da reutilização de resultados para alertas repetidos
- Acessibilidade do fornecedor, taxa de sucesso e percentis de latência
- Em configurações distribuídas: confirmação de que todos os sites conseguem aceder a um fornecedor
Determinístico antes da IA
O contexto é criado primeiro a partir do Livestatus e da API REST. O modelo interpreta um conjunto de dados que não foi responsável por reunir.
Salvaguarda determinística
Se a geração falhar, o conjunto de evidências continua a ser devolvido, permitindo à equipa prosseguir o trabalho.
Utilize o seu próprio modelo
Qualquer endpoint compatível com OpenAI: self-hosted, empresarial, Azure OpenAI ou um fornecedor público. Mantenha o controlo sobre o perímetro dos seus dados.
Executado no site que monitoriza o host
Em configurações distribuídas, a análise é executada no site responsável pelo host, sem passar por um estrangulamento central.
API-first
Integre com as ferramentas que já utiliza
Concebido para pipelines de incidentes
Todas as capacidades estão disponíveis através de uma API REST versionada. Inicie uma análise a partir do seu pipeline de incidentes, importe o relatório para o ticket e anexe as evidências ao canal onde a equipa comunica.
/api/v1/rca/runIniciar uma análise
/api/v1/rca/{job_id}Consultar o estado
/api/v1/rca/{job_id}/report.jsonObter o relatório
/api/v1/chat/queryColocar uma questão
Autenticação Bearer. Callback ou polling. Cerca de quinze minutos para associar uma análise a cada novo incidente.
Piloto
Veja o Pardinus a analisar os seus próprios alertas
Um piloto orientado no seu Checkmk, com o seu endpoint de modelo e os seus serviços mais ruidosos. Se não reduzir o tempo que a sua equipa demora a decidir o que investigar primeiro, não vale a pena instalar.
Começar
Fale-nos do seu ambiente Checkmk
Escolha a conversa mais adequada à sua equipa e indique a dimensão do ambiente e os pontos onde a investigação de incidentes é atualmente mais demorada.
Analisaremos o contexto e responderemos com o próximo passo mais adequado.
Prefere utilizar o e-mail? checkmk@lynxmind.com