Na Lynxmind sempre acreditámos que a inovação a sério acontece quando a tecnologia está nas nossas próprias mãos. Desta vez, decidimos levar isso à letra.
Construímos o nosso próprio servidor de automação com IA, em instalações próprias, da montagem do hardware à instalação de toda a stack de IA e orquestração de fluxos, para alimentar a automação interna sem custos de subscrição e com controlo total dos nossos dados.
A montagem do LYNXMIND
Levou-me de volta à adolescência, quando passava horas a montar computadores para jogos e a afinar cada configuração à procura de desempenho.
Mas o objetivo, desta vez, era bem mais ambicioso: desenhar um servidor de automação com IA de nível de produção, que desse à Lynxmind total independência e controlo.
Especificações do hardware:
- Motherboard: Asus TUF Gaming A620M-Plus (Micro-ATX)
- Processador: AMD Ryzen 7 8700G “Zen 4” (8 núcleos, 4,2–5,1 GHz, 24 MB de cache)
- Memória: 128 GB Corsair Vengeance RGB DDR5 a 6000 MHz (CL30)
- Armazenamento: 4 TB WD Green SN350 (2 × 2 TB NVMe PCIe 3.0 ×4)
E sim, brilha lindamente quando está a trabalhar.
A base: Ubuntu, Kubernetes e Rancher
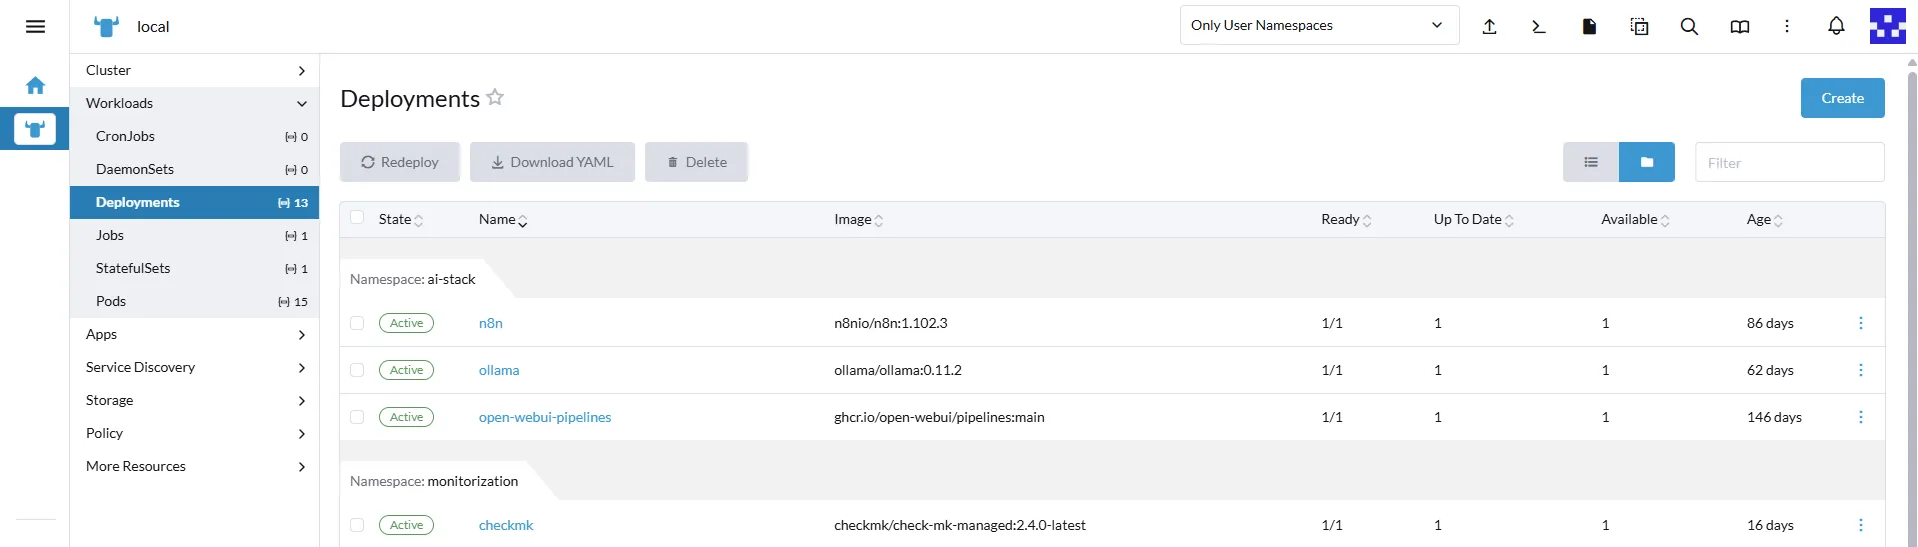
Sobre este hardware instalámos o Ubuntu 24.04 LTS (kernel 6.14.0-29-generic) e montámos um cluster Kubernetes leve com K3s, gerido através do Rancher.
A nossa stack privada de LLM: Ollama e Open WebUI
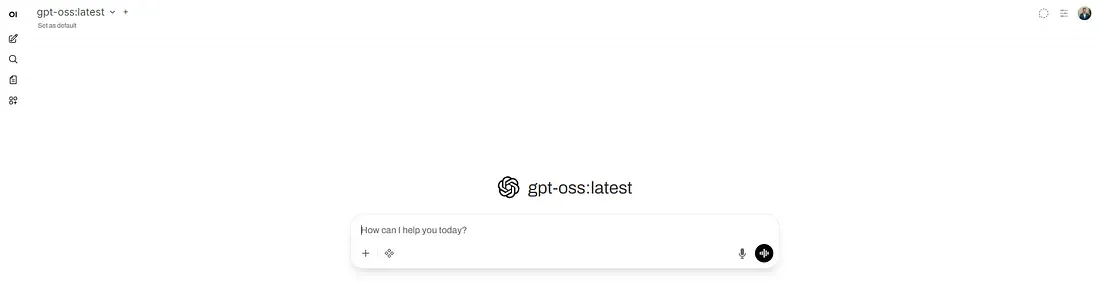
Em vez de depender de APIs externas, instalámos o Ollama, um executor de modelos com alojamento próprio que nos permite correr LLMs localmente. Nesta experiência usámos o gpt-oss:20b, um modelo open source com excelente capacidade de raciocínio e de síntese, ideal para tarefas em que a privacidade e o controlo de custos são decisivos.
Acrescentámos o Open WebUI por cima, para dar uma interface de conversa simples aos modelos. Juntos, formam um ambiente de IA interno, sem consumo de tokens e totalmente privado.
A camada de automação: n8n com alojamento próprio
A seguir instalámos o n8n, uma plataforma de automação open source, dentro do mesmo ambiente Kubernetes.
Funciona como tecido conjuntivo entre os nossos serviços e os modelos de IA locais: capta eventos, transforma dados e executa lógica através de uma interface visual simples.
As maiores vantagens:
- 💰 Custo zero: sem tokens, sem escalões de subscrição.
- 🔒 Dados privados: cada instrução, ficheiro e resultado fica dentro da nossa infraestrutura, sem exposição.
Automatizar a forma como tratamos candidaturas
Um dos primeiros desafios que decidimos atacar com o LynxServer foi algo muito real em qualquer empresa em crescimento: o fluxo interminável de currículos.
Até então, analisar currículos era um processo manual e demorado. Cada nova candidatura significava abrir ficheiros, procurar palavras-chave e tentar recordar quem tinha experiência em quê. Era lento, inconsistente e claramente não era o melhor uso do nosso tempo.
Construímos, por isso, um sistema para resolver o problema.
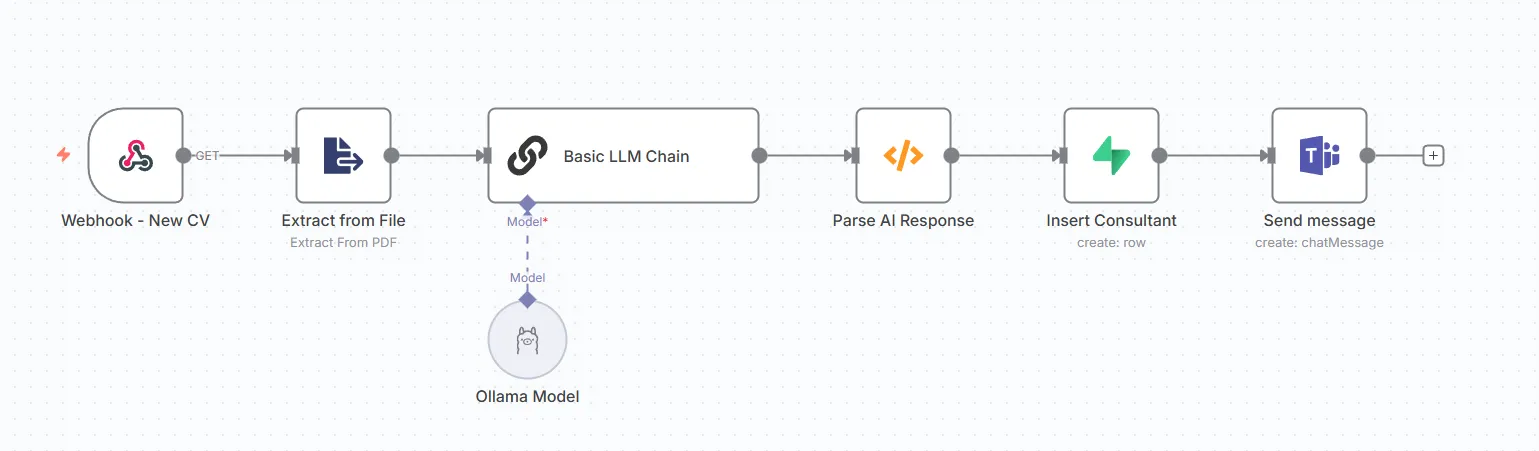
Agora, quando chega um currículo, por e-mail ou por upload, o n8n entra em ação. Extrai automaticamente o anexo, converte-o de PDF para texto e envia-o para o nosso LLM local, a correr no Ollama. A IA lê o documento e produz um resumo estruturado: competências principais, anos de experiência, nível de senioridade e até uma breve descrição do perfil.
Esses dados estruturados são depois inseridos diretamente no Supabase, a nossa base de dados interna em PostgreSQL, também alojada no Kubernetes. A partir daí, podemos pesquisar e filtrar candidatos por competência de imediato, sem que ninguém tenha lido um único currículo.
No fim, a equipa de Recursos Humanos recebe uma mensagem sobre o fluxo processado.
Encontrar o perfil certo num instante
Não ficámos por aí. Com os candidatos estruturados na base de dados, invertemos o fluxo.
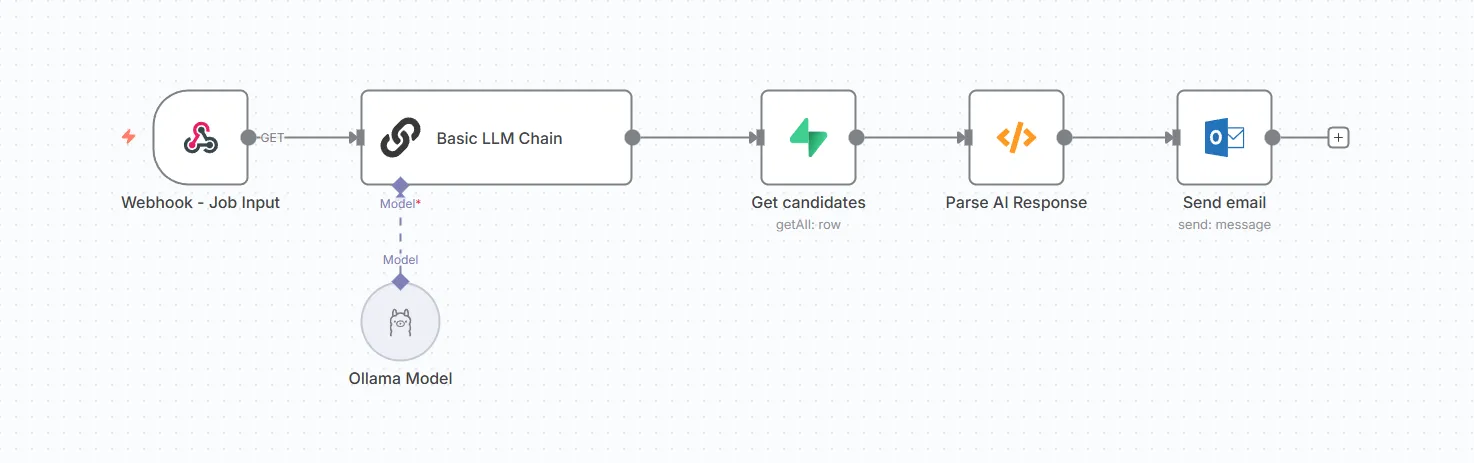
Quando é criada uma nova vaga, o n8n envia a descrição para o Ollama, que identifica as competências e a experiência essenciais.
Depois, através de consultas ao Supabase, o sistema compara automaticamente esses requisitos com os perfis guardados e devolve uma lista ordenada dos melhores candidatos, com pontuação de correspondência e resumo.
O que antes levava horas de leitura passou a acontecer em segundos, em privado, dentro da nossa própria infraestrutura. É como ter um assistente de recrutamento inteligente, que nunca dorme e nunca deixa fugir dados.
Notas finais
Este projeto lembrou-me porque me apaixonei pela tecnologia.
Da montagem do hardware ao momento em que vi os nós do Kubernetes a acender, foi como construir o meu primeiro computador de jogos, só que desta vez alimenta algo bem maior.
Na Lynxmind, estamos a provar que a IA não tem de viver na cloud de outra pessoa.
Resumo da stack
- Hardware: computador montado à medida (Ryzen 7 8700G, 128 GB de RAM, 4 TB NVMe)
Computação local de elevado desempenho e eficiente em energia - Sistema operativo: Ubuntu 24.04 LTS
Distribuição Linux estável e amiga de quem desenvolve - Orquestração: K3s e Rancher
Kubernetes leve, com gestão visual - Runtime de IA: Ollama e Open WebUI
Alojamento e utilização de LLMs locais - Plataforma de automação: n8n
Automação visual de fluxos de trabalho - Base de dados: Supabase (PostgreSQL)
Armazenamento de dados de candidatos e vagas