Em outubro apresentámos o LynxServer, o nosso primeiro servidor de IA privado. Provou um princípio: na Lynxmind, a IA vive em máquinas que são nossas. Esta é a versão de produção dessa ideia.
A máquina
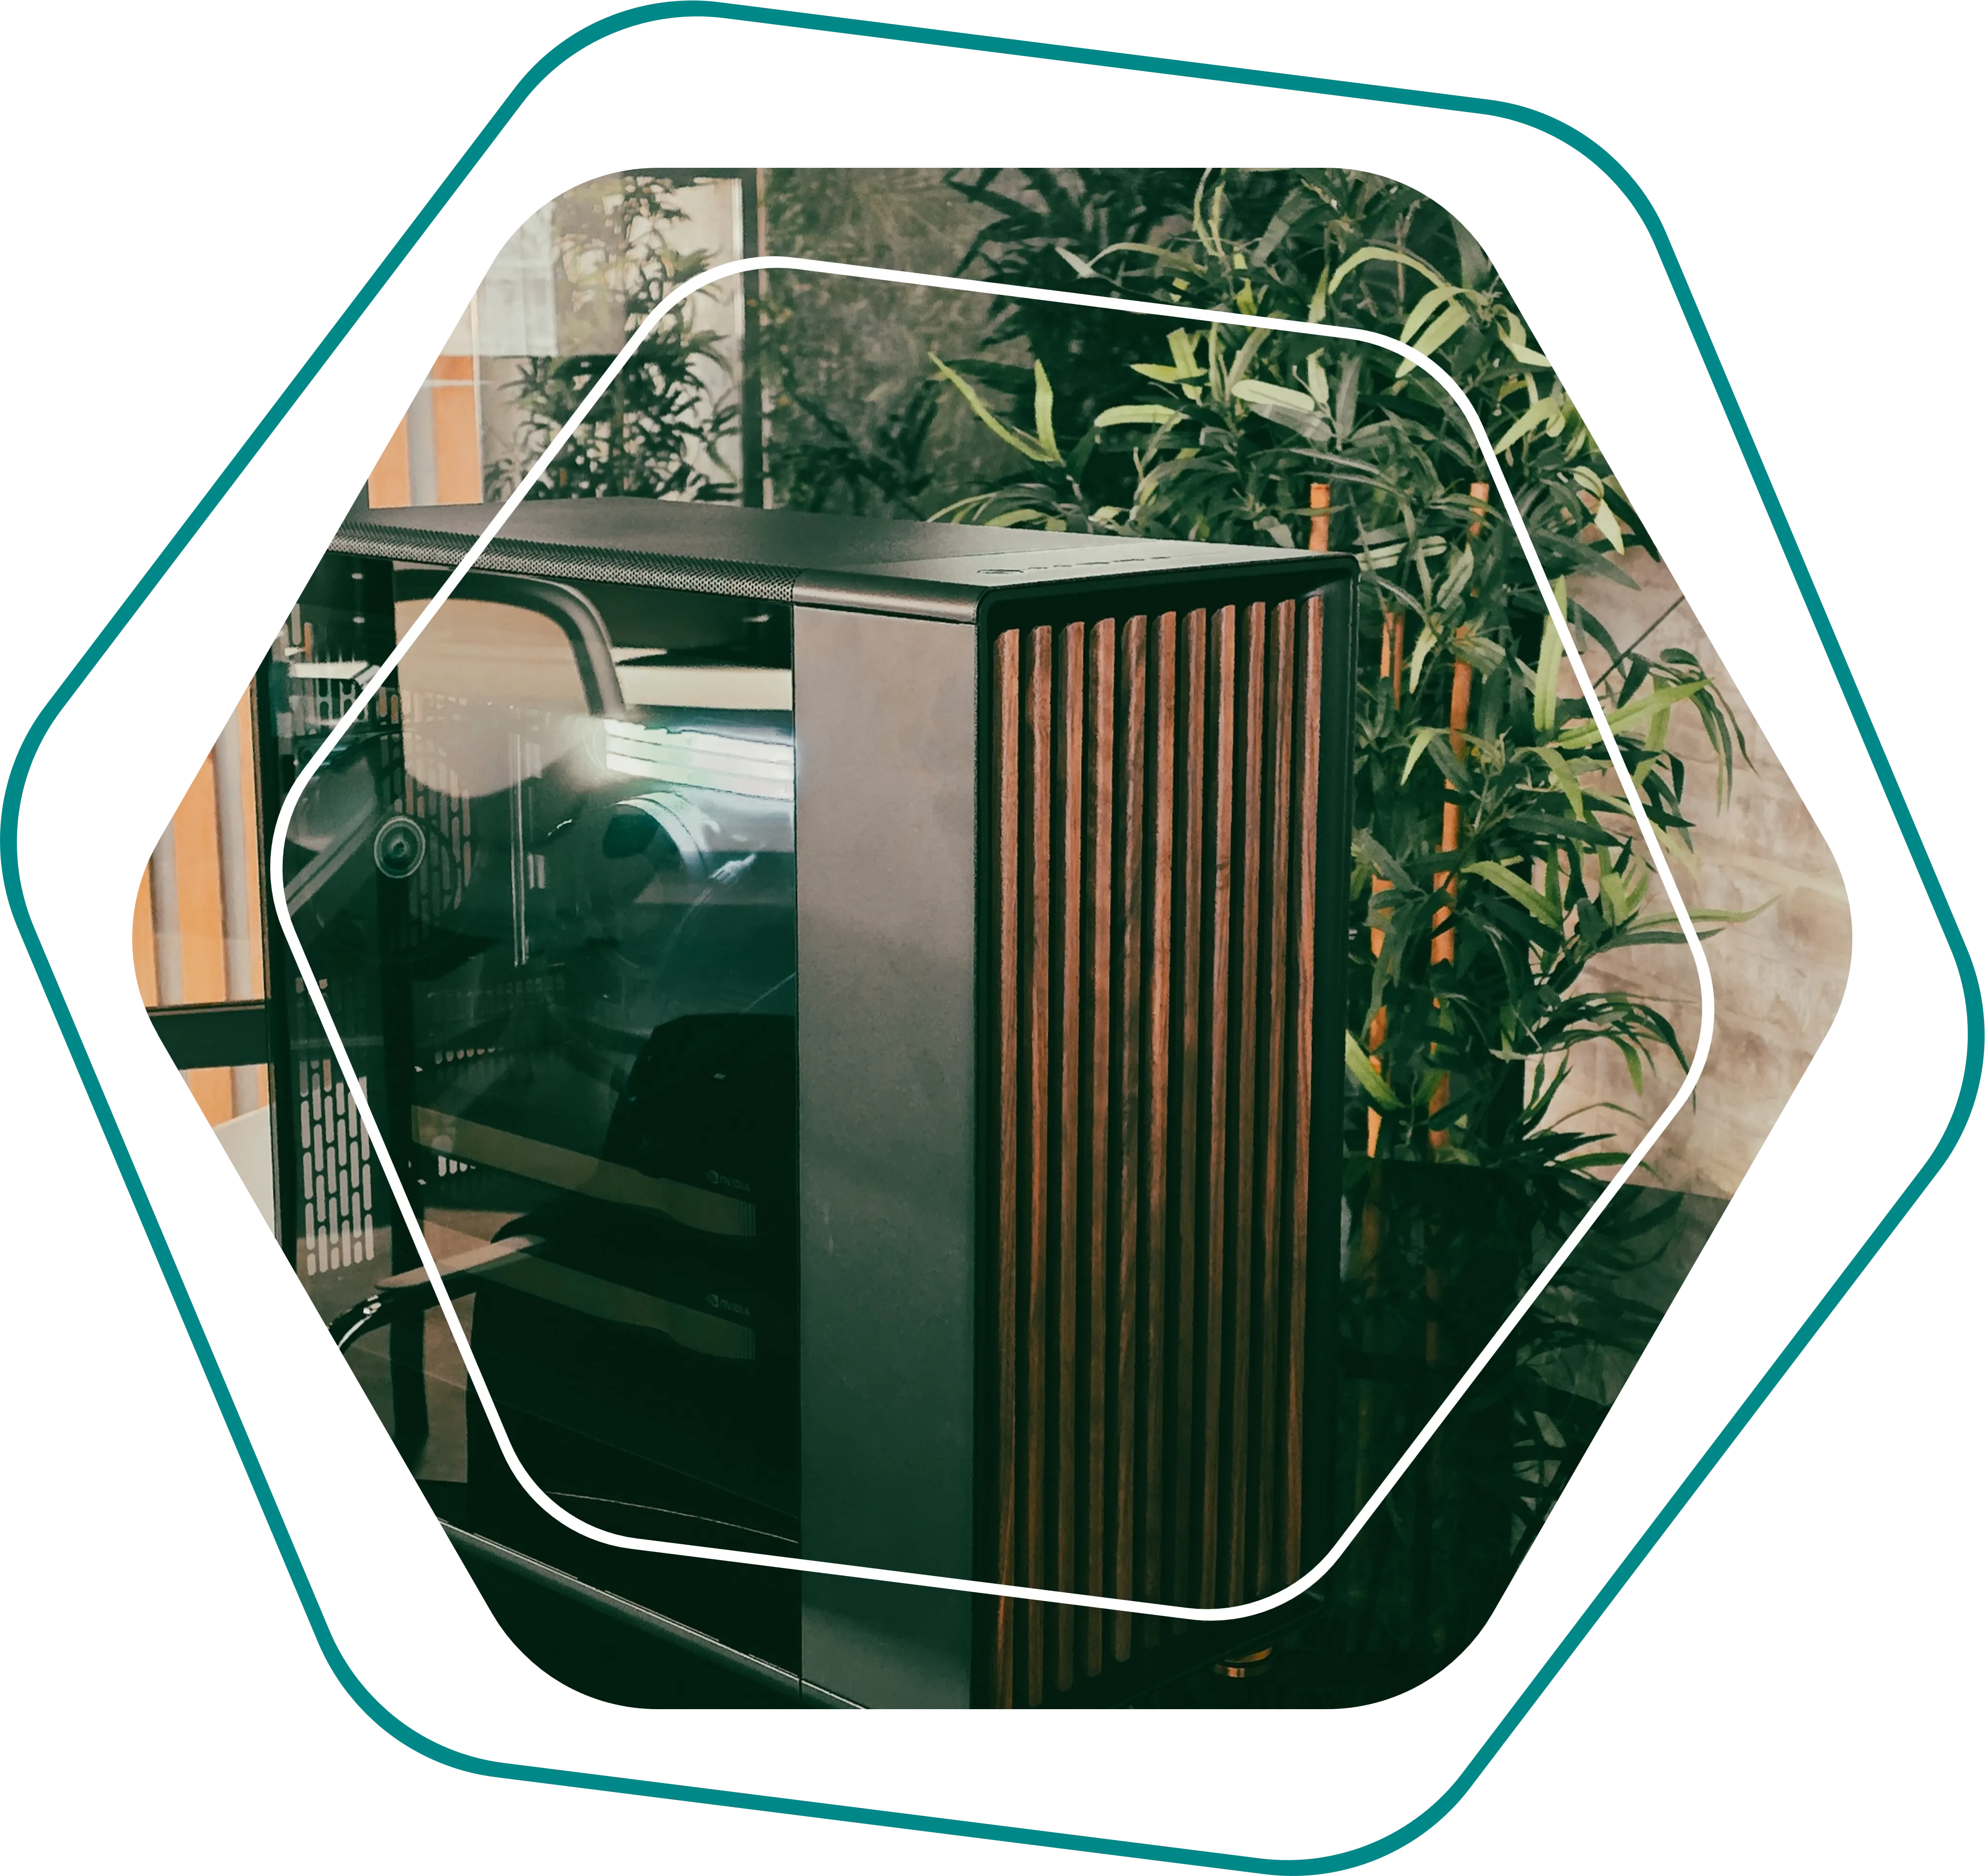
Duas GPUs NVIDIA RTX PRO 6000 Blackwell Workstation Edition num único chassis.
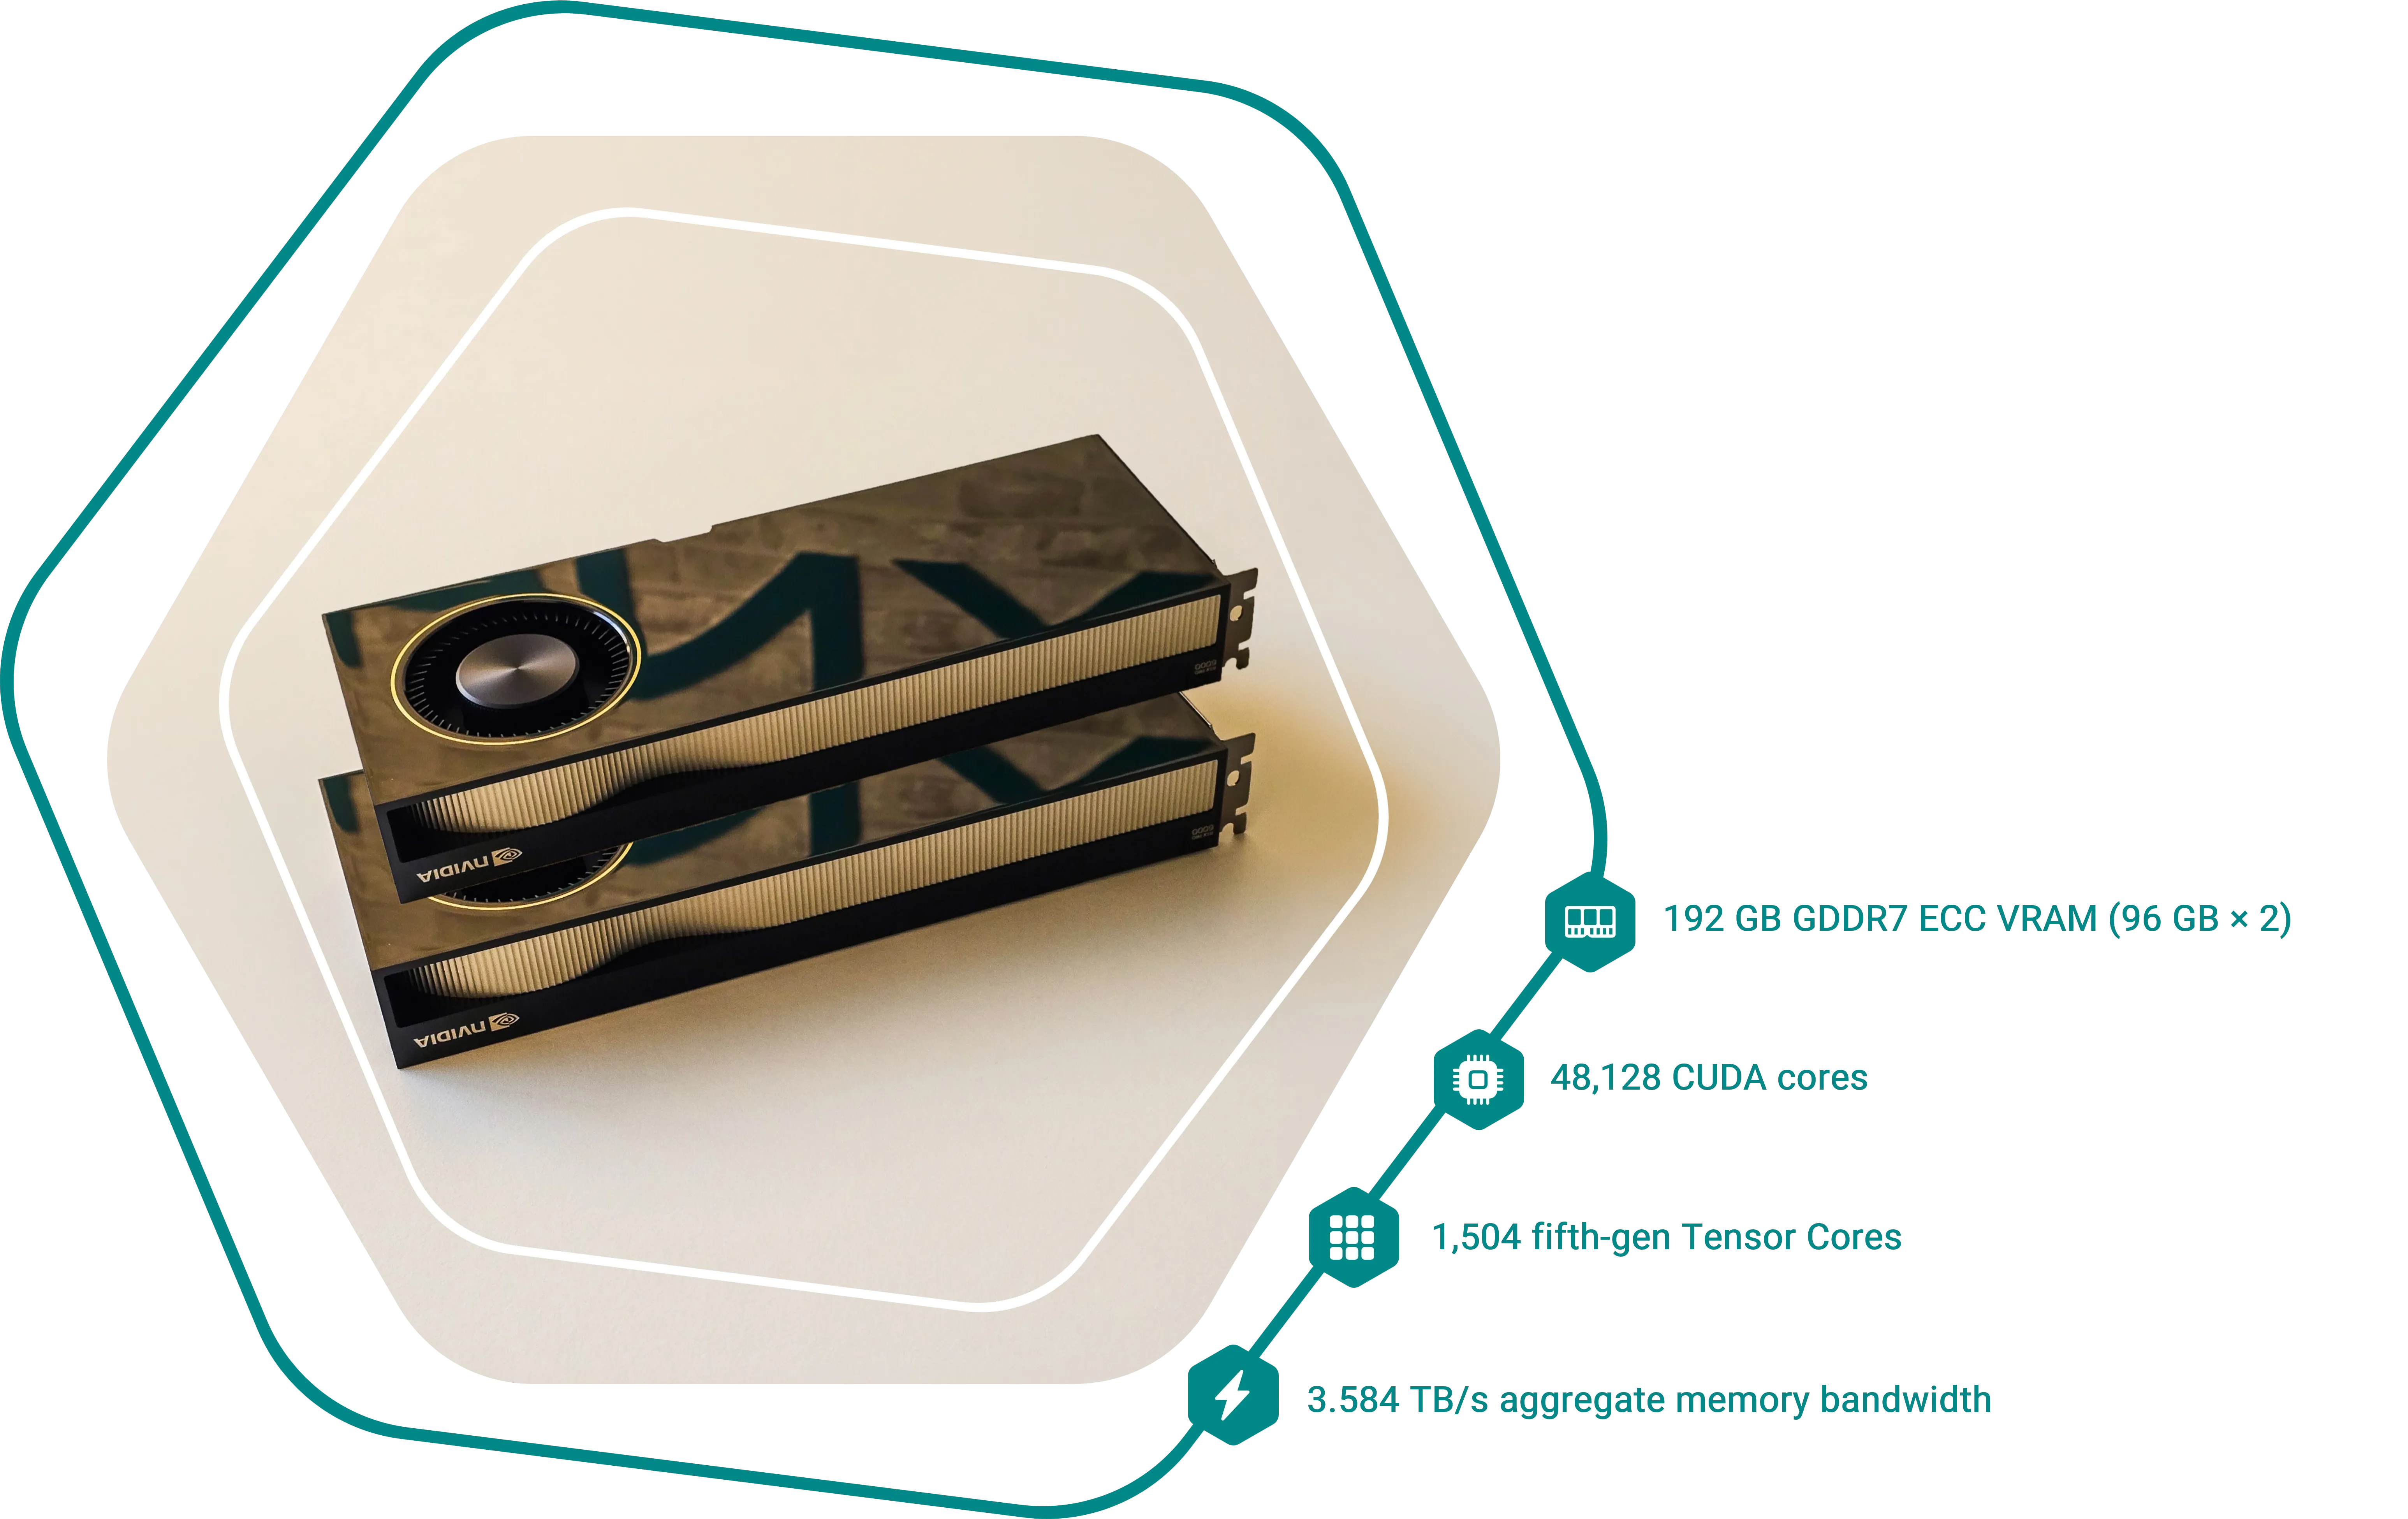
Montada por nós. Afinada por nós. Nossa.
O modelo
À data deste artigo, corremos o Gemma 4 (31b), a família de modelos de pesos abertos da Google, localmente no servidor.Com 192 GB de VRAM, o modelo é executado em alta precisão, corre com janelas de contexto completas e responde toda a equipa em paralelo.
Desempenho real
Números da nossa utilização atual em produção:
~60 sessões em simultâneo256k de contexto por sessão~52 tokens por segundo, por utilizador
Isto representa metade da equipa da Lynxmind, além de consultores, agentes e automações, tudo correr numa única máquina, em paralelo, sem filas de espera. É como ter um Claude Sonnet 4.5 privado só para a empresa.
A stack: Open WebUI e LiteLLM
Duas peças assentam sobre as GPU:
O Open WebUI dá à equipa uma interface de conversa limpa, ao estilo do ChatGPT, ligada à nossa própria infraestrutura.. A mesma experiência que já todos conhecem, sem curva de aprendizagem.
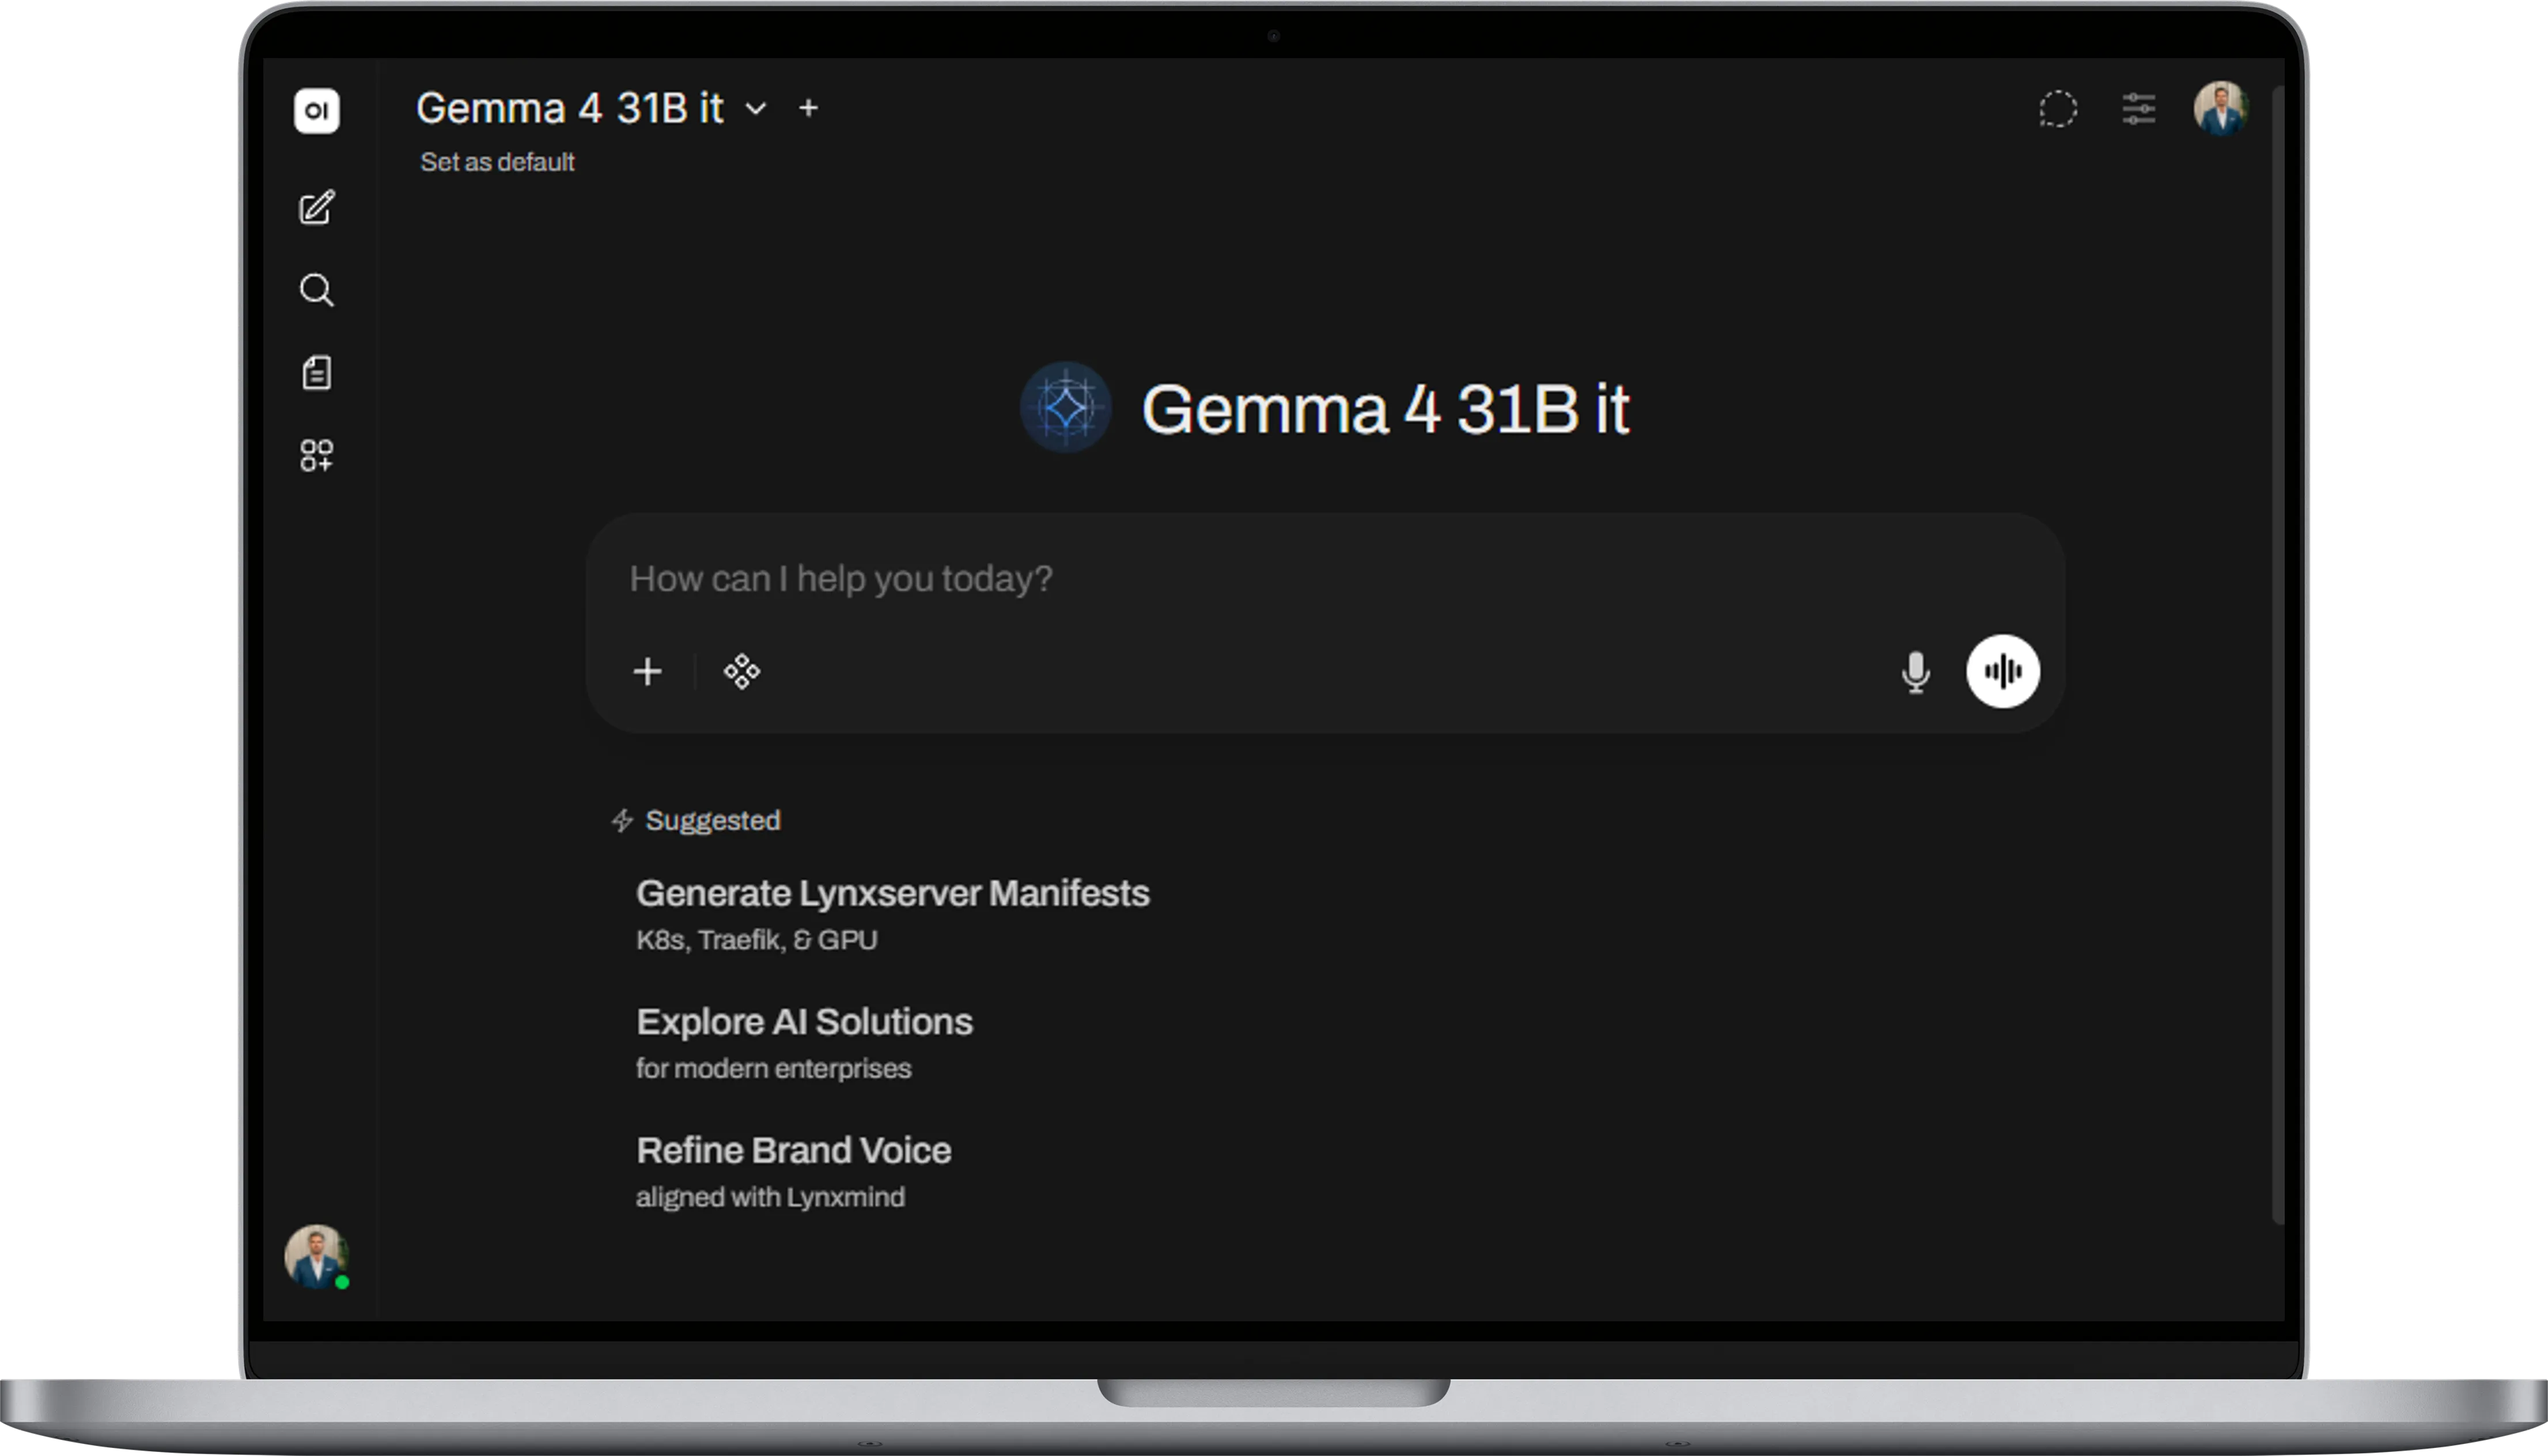
O LiteLLM funciona como o nosso gateway interno de IA:
· Autenticação centralizada, com chaves virtuais por utilizador.
· Limites de utilização e encaminhamento dentro do cluster.
· Registo de auditoria completo de cada pedido.
· Salvaguardas aplicadas no gateway: filtros contra injeção de prompts, verificação de dados pessoais e políticas de conteúdo.
É isto que transforma uma estação de trabalho potente numa plataforma governada.
As contas
Na Lynxmind, a IA corre sem parar. Agentes OpenClaw e Hermes ativos 24 horas por dia. O Guardian a correlacionar telemetria e a executar pipelines multiagente. Projetos de automação de currículos. Fluxos n8n. Reconhecimento ótico de faturas. Experiências internas.
E depois há o custo por pessoa. Uma licença típica do Claude, da Anthropic, ronda os 20 € por consultor, por mês, antes de entrar qualquer utilização intensiva. Multiplique isso por uma equipa de engenharia e passa a ser uma rubrica com peso, que cresce a cada nova contratação.
Os nossos consultores apontam agora o Claude Code, dentro do VS Code, diretamente para o endpoint da API do nosso servidor. A mesma experiência de desenvolvimento com agentes. Zero licenciamento por posto. Zero código-fonte a sair de casa.
Numa API comercial, a fatura mensal acumulada torna-se uma rubrica que a gestão nota. No nosso servidor, o custo marginal de mais uma inferência é eletricidade.
O hardware paga-se em meses. Cada pedido a partir daí é, na prática, gratuito.
Deixámos também de estar expostos às oscilações de preço dos fornecedores de IA. A inteligência vai ser uma mercadoria como a água ou a eletricidade, mas sem regulação estatal. Optámos por ser donos da nossa.
A maior vitória, porém, é cultural: o custo deixa de ser uma razão para dizer que não. Os engenheiros deixam de racionar. Os consultores deixam de hesitar. A inovação deixa de ser orçamentada e passa a estar no ar que se respira.
As três condições, repetidas
Esta é a mesma arquitetura que defendemos para os nossos clientes:
· Soberania. Os dados nunca saem da nossa infraestrutura.
· Controlo de custos. Sem tokens. Sem faturação por posto.
· Privacidade. Prompts, código e resultados ficam em hardware que é nosso.
O que defendemos, praticamos.
Para terminar
O primeiro LynxServer foi uma prova. Este é uma plataforma.
Hardware montado pela nossa equipa. Modelo de pesos abertos a correr localmente. Open WebUI para a equipa, LiteLLM a impor as salvaguardas. Zero tráfego para fora.
Na Lynxmind, a soberania da IA não é um slogan. É uma lista de componentes, um bastidor e uma equipa que sabe juntar tudo isso.